Jo mer du programmerer, desto oftere oppdager du at du skriver det samme på nytt. Gode programmerere skriver koden én gang og bruker den mange ganger: i flere deler av samme program, i neste prosjekt, og noen ganger i andres programmer. Dette kapittelet handler om å skrive kode som er gjenbrukbar, og om å bruke det andre har skrevet.
Du lærer å lage funksjoner som kan brukes på mange måter, å dokumentere dem slik at andre (og du selv om en måned) forstår dem, å dele koden i moduler og biblioteker, å bruke standardbiblioteket og tredjepartspakker, og å gjøre en spesiell løsning om til en generell. Dette er kompetansemålet om å generalisere løsninger ved å utvikle og bruke gjenbrukbar programkode.
Delkapitlene om moduler (3.2) og tredjepartspakker (3.3.2) gjør du i VS Code, siden de handler om flere filer og installerte pakker. De andre kan du gjøre i boka og i notatboka i nettleseren.
Notatboka har flere oppgaver, som rettes med sjekk(). Den kan brukes i nettleseren eller i VS Code.
Læringsmål
Etter å ha arbeidet med kapittelet skal du kunne
lage funksjoner med standardverdier og nøkkelordargumenter, og dokumentere dem med docstrings og typehint,
dele et program i moduler og lage et eget bibliotek,
bruke standardbiblioteket, og installere og bruke tredjepartspakker,
gjøre en spesiell løsning generell, og avgjøre når det lønner seg.
3.1 Parametere, returverdier og dokumentasjon
Du kan allerede lage funksjoner. Her gjør du dem mer fleksible med standardverdier og nøkkelord, og lærer å dokumentere dem slik at andre forstår hva de gjør.
3.1.1 Standardverdier og nøkkelordargumenter
Du har brukt standardverdier og nøkkelordargumenter lenge uten å tenke over det. print("a", "b") setter mellomrom mellom ordene, men med print("a", "b", sep="-") setter den en strek. round(3.14159) runder til heltall, mens round(3.14159, 2) gir to desimaler. Funksjonene har standardverdier for det du ikke oppgir, og du kan velge ut det du vil endre med et nøkkelord:
I dette delkapittelet lærer du å lage funksjoner som virker på samme måte. Da kan én funksjon brukes på mange måter, og det er kjernen i gjenbrukbar kode.
Læringsmål
Etter dette delkapittelet skal du kunne
lage funksjoner med standardverdier for parametere,
kalle funksjoner med nøkkelordargumenter, og forklare forskjellen på posisjonelle argumenter og nøkkelordargumenter,
unngå fellen med en liste som standardverdi,
lage funksjoner som tar et variabelt antall argumenter med *args.
Standardverdier
En parameter kan få en standardverdi. Den brukes hvis den som kaller funksjonen, ikke oppgir noen verdi.
Parametrene hilsen og tegn har standardverdier, så de kan utelates når funksjonen kalles. navn har ingen standardverdi og må alltid oppgis. Parametre med standardverdi må stå etter dem uten.
Første kall bruker standard mva (\(25\) %) og gir 125.0. Andre kall oppgir \(15\) % (matvare) og gir 230.0.
AdvarselRekkefølgen på parametere
def hils(hilsen="Hei", navn): er en syntaksfeil. Parametre med standardverdi må stå sist. Python sier non-default argument follows default argument.
Nøkkelordargumenter
Når en funksjon har flere standardverdier, er det tungvint å måtte sende inn alle verdiene i rekkefølge. Med nøkkelordargumenter skriver du navnet på parameteren, og kan velge ut akkurat det du vil endre:
Første kall hopper over hilsen, og endrer bare tegn. I andre kall står argumentene i en annen rekkefølge enn parametrene, men det går bra, siden hver av dem har et navn.
RegelPosisjonelle og nøkkelordargumenter
Posisjonelle argumenter matches mot parametrene i rekkefølge: hils("Kari", "Hallo").
Nøkkelordargumenter matches på navn: hils("Kari", tegn="?"). De kan stå i hvilken som helst rekkefølge.
I et kall må alle posisjonelle argumenter stå før nøkkelordargumentene.
Hver parameter kan bare få verdi én gang.
Nøkkelord gjør også koden lettere å lese. pris_med_mva(200, mva=15) sier tydelig hva \(15\) er, mens pris_med_mva(200, 15) krever at du husker hva det andre tallet betyr.
EksempelHvilke kall er gyldige?
Funksjonen er def beregn(a, b=2, c=3). Hvilke kall er gyldige, og hva er a, b og c i hvert av dem?
beregn(1)
beregn(1, 5)
beregn(1, c=9)
beregn(c=9, a=1)
beregn(b=5)
HintHint
a har ingen standardverdi, så den må alltid oppgis.
LosningLøsning
Gyldig: a=1, b=2, c=3.
Gyldig: a=1, b=5, c=3.
Gyldig: a=1, b=2, c=9.
Gyldig: a=1, b=2, c=9. Nøkkelordargumenter kan stå i en annen rekkefølge.
Ugyldig. a mangler, og det gir TypeError: beregn() missing 1 required positional argument: 'a'.
En liste som standardverdi
Det er en fallgruve i Python som alle går i: aldri bruk en liste (eller ordbok) som standardverdi. Se hva som skjer:
Vi ville ha [1], [2] og [3], men får [1], [1, 2] og [1, 2, 3]. Standardverdien lages én gang, når funksjonen defineres, og den samme listen brukes i alle kall. Løsningen er å bruke None som standardverdi, og lage en ny liste inni funksjonen:
def legg_til(x, liste=None):if liste isNone: liste = [] liste.append(x)return listeprint(legg_til(1))print(legg_til(2))
[1]
[2]
Nå får hvert kall sin egen nye liste.
Et variabelt antall argumenter
Noen ganger vet du ikke hvor mange verdier funksjonen skal få. Da setter du en stjerne foran parameternavnet. Alle argumentene samles i et tuppel:
def summer(*tall): totalt =0for x in tall: totalt += xreturn totaltprint(summer(1, 2, 3))print(summer(10))print(summer())
6
10
0
Navnet *args er vanlig, men du kan velge selv. Stjernen virker også andre veien: print(*liste, sep="-") pakker ut elementene i liste som egne argumenter.
tall = [1, 2, 3, 4, 5]print(*tall, sep="-")
1-2-3-4-5
AdvarselVanlige feil
En parameter uten standardverdi etter en med: def f(a=1, b):. Det gir SyntaxError.
En liste eller ordbok som standardverdi (liste=[]). Bruk None.
Å blande rekkefølgen i kallet: et posisjonelt argument etter et nøkkelordargument, som hils(navn="Kari", "Hallo").
Å oppgi samme parameter to ganger: hils("Kari", navn="Ola") gir TypeError.
Å glemme at *tall gir et tuppel, ikke en liste.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Standardverdien [] lages én gang, når funksjonen defineres, og den samme listen brukes i alle kall. Bruk None, og lag en ny liste i funksjonen:
def handleliste(vare, liste=None):if liste isNone: liste = [] liste.append(vare)return liste
def handleliste(vare, liste=None):if liste isNone: liste = [] liste.append(vare)return liste
Kodeoppgaver
Disse oppgavene rettes automatisk. Skriv funksjonen i editoren og trykk Kjør. Testene kaller funksjonen din på flere måter.
ExercisePris med moms
Lag funksjonen pris_med_mva(pris, mva=25) som gir prisen med merverdiavgift.
Start med def pris_med_mva(pris, mva=25):, og returner pris * (100 + mva) / 100.
ExerciseHilsen med valg
Lag funksjonen hils(navn, hilsen="Hei", tegn="!") som gir for eksempel Hei, Kari!.
Bruk en f-streng: f"{hilsen}, {navn}{tegn}".
ExercisePotens med standard eksponent
Lag funksjonen potens(grunntall, eksponent=2). Uten eksponent skal den gi kvadratet.
grunntall ** eksponent regner ut potensen.
ExerciseFinn feilen: listen som husker
Funksjonen skal gi en ny liste for hvert kall, men husker forrige liste. Rett den.
Bruk liste=None som standardverdi, og lag liste = [] inni funksjonen hvis den er None.
ExerciseSnittet av hvor mange tall som helst
Lag funksjonen snitt(*tall) som gir gjennomsnittet av alle tallene du sender inn.
tall er et tuppel. Du kan bruke sum(tall) og len(tall).
Utfordringer
ExerciseEn linje av tegn
Lag funksjonen lag_linje(tegn="-", lengde=10) som gir en tekst med tegn gjentatt lengde ganger.
En tekst ganget med et tall gjentar teksten: "ab" * 3 er "ababab".
ExerciseUtskrift med skilletegn
Skriv ut tallene i lista på én linje, med en strek mellom, med én print og uten løkke: 1-2-3-4-5.
print(*tall, sep="-") pakker ut lista som egne argumenter og setter streken mellom.
ExerciseHvorfor None og ikke en tom liste?
Forklar med egne ord hvorfor vi bruker None som standardverdi og lager listen inni funksjonen, og hvorfor det ikke går bra å skrive liste=[].
AnswerFasit
Standardverdier regnes ut én gang, når funksjonen defineres, ikke hver gang den kalles. Med liste=[] lages én tom liste som alle kall deler. Hvert append endrer denne ene listen, så neste kall starter med det forrige kallet la til. Med None som standard og if liste is None: liste = [] inni funksjonen lages en ny tom liste for hvert kall. Dette gjelder alle typer som kan endres, som lister og ordbøker. Tall, tekster og None kan ikke endres, og er trygge som standardverdier.
Bruk aldri [] eller {} som standardverdi. Bruk None.
3.1.2 Docstrings og typehint
Se på denne funksjonen:
def f(a, b, c=0.5):return a * b * (1- c)
Hva gjør den? Hva er a, b og c? Er c en prosent, eller en andel? Om en uke har ikke du heller peiling, og andre som skal bruke den, har ingen sjanse. Gode funksjoner har dokumentasjon som forteller hva de gjør, og typehint som forteller hvilke typer de tar og gir. Begge deler står i selve koden.
Læringsmål
Etter dette delkapittelet skal du kunne
skrive en docstring som forklarer hva en funksjon gjør, hva den tar inn og hva den gir tilbake,
bruke help() og .__doc__ til å lese dokumentasjon,
skrive typehint for parametere og returverdi, også for lister og None,
forklare hva typehint gjør og ikke gjør.
Docstrings
En docstring er en tekst med tre anførselstegn som står som aller første setning i en funksjon. Python tar vare på den, og help() viser den.
DefinisjonDocstring
def areal(bredde, hoyde):"""Gir arealet av et rektangel."""return bredde * hoyde
Teksten mellom """ er docstringen. Den må stå først i funksjonen, ellers regnes den ikke som docstring.
For korte funksjoner holder én linje. En god første linje sier hva funksjonen gjør, som en kort setning («Gir arealet av …», «Finner det største tallet i …»). For mer kompliserte funksjoner beskriver du parametrene og returverdien. Vi bruker denne formen (kalt Google-stil):
def pris_med_mva(pris, mva=25):"""Gir prisen med merverdiavgift. Args: pris: prisen uten mva, i kroner. mva: mva-satsen i prosent (standard 25). Returns: prisen med mva, i kroner. """return pris * (100+ mva) /100help(pris_med_mva)
Help on function pris_med_mva in module __main__:

pris_med_mva(pris, mva=25)
    Gir prisen med merverdiavgift.

    Args:
        pris: prisen uten mva, i kroner.
        mva: mva-satsen i prosent (standard 25).

    Returns:
        prisen med mva, i kroner.
help() viser signaturen og docstringen. Du kan også hente teksten direkte med pris_med_mva.__doc__. VS Code viser den når du holder musepekeren over funksjonen, så dokumentasjonen følger deg overalt der du bruker funksjonen.
RegelKommentarer og docstrings
En docstring forklarer hva funksjonen gjør, for den som bruker den.
En kommentar (# ...) forklarer hvorfor en bestemt linje er skrevet slik, for den som leser koden.
Kommentarer som bare gjentar koden (x = x + 1 # legger til 1) hjelper ingen.
EksempelSkriv en docstring
Lag en docstring til funksjonen, som sier hva den gjør.
def er_partall(n):return n %2==0
HintHint
En enkel setning om hva funksjonen gir tilbake og når, er nok. Husk tre anførselstegn.
LosningLøsning
def er_partall(n):"""Gir True for partall, ellers False."""return n %2==0print(er_partall.__doc__)
Gir True for partall, ellers False.
Docstringen står først i funksjonen, og __doc__ gir teksten tilbake.
Typehint
Typehint forteller hvilke typer funksjonen forventer og gir. Etter parameternavnet skriver du kolon og typen, og etter parentesen skriver du -> og returtypen:
def areal(bredde: float, hoyde: float) ->float:"""Gir arealet av et rektangel."""return bredde * hoydeprint(areal(3, 4))print(areal.__annotations__)
Typehint håndheves ikke av Python. De er hint for deg, for andre som leser koden, og for editoren. VS Code viser typene når du bruker funksjonen, og understreker kall som ikke passer. Se hva som skjer hvis du bryter dem:
print(areal("a", 3))
aaa
Python kjører funksjonen uansett: "a" * 3 er en gyldig operasjon på tekst. Typehintet stoppet ikke noe, det er bare editoren som ville advart.
EksempelLegg til typehint
Legg til typehint på funksjonen: snitt tar en liste med tall og gir et desimaltall.
def snitt(tall):returnsum(tall) /len(tall)
HintHint
Parameteren er list[float], og returverdien er float.
LosningLøsning
def snitt(tall: list[float]) ->float:"""Gir snittet av tallene i lista."""returnsum(tall) /len(tall)print(snitt([4, 5, 3, 6, 4]))
4.4
Typen list[float] sier at parameteren er en liste med tall. Heltall regnes som gyldige der en float er ventet.
AdvarselVanlige feil
Docstringen står ikke først i funksjonen. Da er __doc__ tom, og help() viser ingenting.
Å tro at typehint stopper feil bruk. De gjør det ikke, men editoren advarer.
Typehint som ikke stemmer: -> int på en funksjon som gir None.
Å bruke gamle List[int] fra typing. Fra Python 3.9 skriver vi bare list[int].
Docstringer som bare sier det samme som funksjonsnavnet: """Funksjonen areal.""".
Å glemme å oppdatere docstringen når funksjonen endres.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHva betyr typehintet?
Hva forteller hver av disse funksjonene om hva de tar inn og gir tilbake?
def f(x: int) -> str:
HintHint
Etter kolon står typen på parameteren, og etter -> står typen på det funksjonen gir tilbake.
AnswerFasit
Tar et heltall og gir en tekst.
def g(navn: str, alder: int = 18) -> None:
HintHint
Etter kolon står typen på parameteren, og etter -> står typen på det funksjonen gir tilbake.
AnswerFasit
Tar en tekst (navn) og et heltall (alder, med standardverdi \(18\)), og gir ingenting tilbake (None).
def h(tall: list[int]) -> int | None:
HintHint
Etter kolon står typen på parameteren, og etter -> står typen på det funksjonen gir tilbake.
AnswerFasit
Tar en liste med heltall og gir enten et heltall eller None.
ExerciseHva gjør help()?
Etter at du har skrevet def kvadrat(x): """Gir x i andre."""; return x * x, hva skriver kvadrat.__doc__ ut? Hva hvis docstringen stod etter return-linja?
HintHint
Docstringen må være første setning i funksjonen.
AnswerFasit
Med docstringen først skriver kvadrat.__doc__ ut teksten: Gir x i andre. Står den etter return, er den ikke en docstring, men en tekst som aldri blir kjørt (siden koden stopper på return), og kvadrat.__doc__ er None.
Nivå 2
ExerciseFinn feilen: docstringen
Funksjonen skal ha en docstring, men help() viser ingenting.
def dobbel(x):return x *2"""Gir det doble av x."""
Forklar feilen og rett den.
HintHint
Hvor må docstringen stå, og hvorfor teller ikke teksten etter return?
AnswerFasit
Docstringen står etter return, og må stå først i funksjonen. Teksten etter return er bare en tekst som aldri blir kjørt. Flytt den:
def dobbel(x):"""Gir det doble av x."""return x *2
ExerciseTypehint som ikke stemmer
Hva er galt med typehintene, og hva skjer når funksjonen kalles?
Er "hei" et heltall? Hva gir funksjonen egentlig tilbake?
AnswerFasit
Funksjonen tar en tekst og gir en tekst, så begge typehintene skulle vært str. Python bryr seg ikke om typehint, så programmet kjører og skriver ieh. Men editoren vil understreke kallet, siden "hei" ikke er en int. Retting: def snu(tekst: str) -> str:.
Kodeoppgaver
Disse oppgavene rettes automatisk. Testene sjekker funksjonene, og også at docstring og typehint finnes.
ExerciseLegg til en docstring
Funksjonen mangler docstring. Legg til en som forklarer hva den gjør.
Skriv en tekst med tre anførselstegn som aller første linje inni funksjonen.
ExerciseLegg til typehint
Legg til typehint: b og h er desimaltall, og funksjonen gir et desimaltall.
Skriv b: float, h: float i parentesen, og -> float før kolonet.
ExerciseTypehint for lister
Legg til typehint: funksjonen tar en liste med tekster og gir antall tegn i det lengste ordet, som et heltall.
En liste med tekster skrives list[str].
ExerciseFinn feilen: docstringen står feil
Docstringen er skrevet, men Python ser den ikke. Rett det.
Flytt docstringen til første linje inni funksjonen.
ExerciseFullt dokumentert funksjon
Lag funksjonen til_fahrenheit(c) som gjør grader celsius om til fahrenheit, med typehint (float inn og ut) og en docstring.
Formelen er \(F = \frac{9}{5} C + 32\). Skriv def til_fahrenheit(c: float) -> float: og docstringen først.
Utfordringer
ExerciseKanskje ingen verdi
Lag funksjonen finn_forste(liste, tegn) som gir indeksen til første forekomst av tegn i lista, eller None hvis den ikke finnes. Typehintet på returverdien skal vise at svaret kan være None.
Typehintet er -> int | None. Gå gjennom lista med indeks, og returner indeksen når du finner tegnet.
ExerciseHva er vitsen med typehint?
Python håndhever ikke typehint. Gi to grunner til at det likevel er lurt å bruke dem.
AnswerFasit
De er dokumentasjon som alltid står i koden: den som leser funksjonen, ser med en gang hva den tar inn og gir ut. (2) Editoren (VS Code) bruker dem til å advare mens du skriver, for eksempel hvis du sender en tekst til en funksjon som venter et tall, og til å foreslå riktige metoder. Det finner feil før programmet kjøres. Et tredje poeng: verktøy som kan sjekke typene automatisk, kan brukes når prosjektet blir stort.
Oppsummering
Docstring
def f(x):"""Gir x i andre."""return x * x
Lang docstring
"""Kort setning.Args: x: hva x er.Returns: hva som gis tilbake."""
Typehint
def f(x: int, y: float=1.5) ->float: ...
Lister og None
list[int]dict[str, int]int|None->None
Lese dokumentasjon
help(f)f.__doc__f.__annotations__
Docstringen står aller først i funksjonen.
Typehint stopper ingenting. De er hjelp til deg og editoren.
Docstringen sier hva funksjonen gjør, kommentarer sier hvorfor.
3.2 Moduler og egne biblioteker
Når et program vokser, deler du det i flere filer. Her lærer du å lage moduler og egne biblioteker, og å bruke dem fra andre programmer.
3.2.1 Dele koden i moduler
Et program som vokser, blir fort uoversiktlig. Når alt står i én fil på flere hundre linjer, er det vanskelig å finne igjen en funksjon, og vanskelig å bruke den i et annet prosjekt. Løsningen er å dele koden i flere filer. Hver fil kalles en modul, og de bruker hverandre med import. Du har brukt moduler hele tiden: math og random er moduler andre har skrevet. Nå lager du dine egne.
Dette delkapittelet gjør du i VS Code, siden det handler om flere filer i en mappe.
Læringsmål
Etter dette delkapittelet skal du kunne
forklare hva en modul er, og lage en modul i en egen fil,
importere fra egne moduler med import, from ... import og as,
bruke if __name__ == "__main__": slik at en fil kan både kjøres og importeres,
dele et program i flere filer, og unngå navnekollisjoner med standardbiblioteket.
En modul er en fil
Enhver Python-fil er en modul. Lag en mappe geometri_demo og åpne den i VS Code. Lag fila geometri.py:
PI =3.14159def sirkelareal(r):return PI * r **2def rektangelareal(bredde, hoyde):return bredde * hoyde
Lag så en fil main.py i samme mappe, som bruker modulen:
Linja import geometri leser fila geometri.py (uten .py), og alt der blir tilgjengelig med modulnavnet foran: geometri.sirkelareal(2). Python leter først i mappa programmet ligger i, så filene må ligge ved siden av hverandre.
Tre måter å importere
RegelImport
import geometri henter hele modulen. Du bruker geometri.navn.
from geometri import sirkelareal henter bare det du nevner. Du bruker sirkelareal direkte.
from geometri import rektangelareal as rekt gir navnet et kortere navn, et alias.
Unngå from geometri import *. Da vet du ikke lenger hvor navnene kommer fra, og de kan overskrive hverandre.
from geometri import rektangelareal as rektprint(rekt(2, 5))
Standardpraksis er å skrive alle import-linjene helt øverst i fila. Da ser alle med en gang hva fila trenger.
EksempelHvilken import er best?
Du trenger bare sirkelareal fra geometri i et lite program, og bruker den mange ganger. Hvilken import velger du, og hvordan kaller du funksjonen?
HintHint
Tenk på hva som er kortest og samtidig tydelig.
LosningLøsning
from geometri import sirkelareal er bra: du importerer bare det du trenger, og kaller funksjonen direkte som sirkelareal(2). import geometri fungerer også, men gir lengre kall (geometri.sirkelareal(2)) som til gjengjeld viser at funksjonen kommer fra geometri. Det er en smaksak, men bruk én stil gjennom hele prosjektet.
Kjøre eller importere
Hva skjer hvis modulen har kode som ikke ligger i en funksjon? Legg dette nederst i geometri.py:
Linja øverst kom fra geometri.py da den ble importert. Men kjører du geometri.py direkte, blir resultatet et annet:
geometri lastet, __name__ = __main__
3.14159
12
Hver modul har en variabel __name__. Når fila kjøres, er den "__main__". Når den importeres, er den modulnavnet ("geometri"). Det er dette if __name__ == "__main__": sjekker.
RegelKjøres eller importeres
if__name__=="__main__":# kjøres bare når fila kjøres direkte
Alt som ikke er funksjoner og konstanter, skal stå under denne linja. Da kan andre importere modulen din uten at noe skrives ut eller kjøres. Testkode og små demoer passer fint her.
EksempelHvorfor ikke bare la koden stå?
geometri.py har print(sirkelareal(1)) helt uten if-sjekk. Hva skjer når main.py importerer den, og hvorfor er det et problem?
HintHint
Import kjører hele fila ovenfra og ned.
LosningLøsning
Når main.py kjører import geometri, blir hele geometri.py kjørt. Da skrives 3.14159 ut, selv om main.py aldri ba om det. Skulle andre moduler importere geometri, ville utskriften komme der også. Moduler skal bare definere ting (funksjoner og konstanter), ikke gjøre noe. Det er derfor testkode og utskrifter hører hjemme under if __name__ == "__main__":.
Pass på filnavnene
Python leter først i mappa ditt etter moduler, og deretter i standardbiblioteket. Gir du en fil samme navn som en standardmodul, for eksempel random.py, blir din fil importert i stedet for den ekte. Da får du merkelige feilmeldinger:
Traceback (most recent call last):
  File "/Users/kari/it2/skygge/main.py", line 2, in <module>
    print(random.randint(1, 6))
AttributeError: module 'random' has no attribute 'randint'
Nyere versjoner av Python legger til at filen din har samme navn som standardmodulen, og foreslår å gi den nytt navn. Løsningen er å velge et annet navn på fila. Unngå navn som random, math, statistics og test.
Du vil også merke at Python lager en mappe __pycache__ ved siden av modulene dine. Den inneholder ferdig oversatt kode som gjør import raskere. Den er helt grei å ignorere, og hører ikke hjemme i Git (se .gitignore i 1.4.1).
AdvarselVanlige feil
ModuleNotFoundError: No module named 'geometri': filen ligger ikke i mappa du kjører fra, eller du har skrevet navnet feil. Importer uten .py.
ImportError: cannot import name 'x' from 'geometri': funksjonen heter noe annet i modulen.
Navnet på fila er det samme som en standardmodul (random.py).
Du har glemt if __name__ == "__main__":, så kode kjøres når modulen importeres.
Du kjører koden fra feil mappe, slik at Python ikke finner de andre filene.
To moduler som importerer hverandre (sirkulær import). Del opp slik at bare én av dem trenger den andre.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHva skrives ut?
Mappa har to filer.
tall.py:
def dobbel(x):return x *2print("tall lastet")if__name__=="__main__":print(dobbel(4))
main.py:
import tallprint(tall.dobbel(5))
Hva skrives ut når du kjører main.py?
HintHint
Når fila importeres, er __name__ lik "tall". Når den kjøres, er den "__main__".
AnswerFasit
tall lastet
10
Importen kjører print("tall lastet"), men ikke blokken under if __name__ == "__main__", siden __name__ er "tall". Så skriver main.py ut 10.
tall lastet
10
Importen kjører print("tall lastet"), men ikke blokken under if __name__ == "__main__", siden __name__ er "tall". Så skriver main.py ut 10.
Hva skrives ut når du kjører tall.py?
HintHint
Når fila importeres, er __name__ lik "tall". Når den kjøres, er den "__main__".
AnswerFasit
tall lastet
8
Når tall.py kjøres direkte, er __name__ lik "__main__", så blokken kjøres og skriver ut dobbel(4).
tall lastet
8
Når tall.py kjøres direkte, er __name__ lik "__main__", så blokken kjøres og skriver ut dobbel(4).
ExerciseHvilken import?
Du har en modul verktoy.py med funksjonen kvadrat(x). Skriv importen og kallet som
henter hele modulen
HintHint
Se på reglene for import tidligere i delkapittelet.
AnswerFasit
import verktoy, og kall verktoy.kvadrat(3).
henter bare kvadrat
HintHint
Se på reglene for import tidligere i delkapittelet.
AnswerFasit
from verktoy import kvadrat, og kall kvadrat(3).
henter kvadrat med det nye navnet k
HintHint
Se på reglene for import tidligere i delkapittelet.
AnswerFasit
from verktoy import kvadrat as k, og kall k(3).
Nivå 2
ExerciseFinn feilen: importen virker ikke
Hva er galt, og hva gjør du?
import geometri.py gir ModuleNotFoundError: No module named 'geometri.py'.
HintHint
Se på hva du skriver etter import, hvilke navn modulen faktisk har, og hva fila heter.
AnswerFasit
Du skal importere uten .py: import geometri.
from geometri import omkrets gir ImportError: cannot import name 'omkrets', men geometri.py har funksjonen sirkelomkrets.
HintHint
Se på hva du skriver etter import, hvilke navn modulen faktisk har, og hva fila heter.
AnswerFasit
Navnet må være det samme som i modulen: from geometri import sirkelomkrets.
Du har laget en fil random.py og får AttributeError: module 'random' has no attribute 'randint' når du importerer random.
HintHint
Se på hva du skriver etter import, hvilke navn modulen faktisk har, og hva fila heter.
AnswerFasit
Fila di skygger for standardmodulen. Gi den et annet navn, og slett __pycache__-mappa.
ExerciseHva er riktig sted for koden?
Hvilke av disse bør ligge utenfor if __name__ == "__main__": i en modul, og hvilke bør ligge under?
En funksjon kvadrat(x).
HintHint
Moduler skal bare definere ting. Noe som gjør noe, hører under blokken.
AnswerFasit
og b) ligger utenfor: funksjoner og konstanter skal være tilgjengelige når modulen importeres. c) og d) ligger under if __name__ == "__main__":. De gjør noe (skriver ut, spør brukeren), og skal ikke kjøres når noen bare importerer modulen.
En konstant PI = 3.14159.
HintHint
Moduler skal bare definere ting. Noe som gjør noe, hører under blokken.
Et kall print(kvadrat(3)) for å teste funksjonen.
HintHint
Moduler skal bare definere ting. Noe som gjør noe, hører under blokken.
Et kall som spør brukeren om et tall med input().
HintHint
Moduler skal bare definere ting. Noe som gjør noe, hører under blokken.
Kodeoppgaver
Disse oppgavene rettes automatisk. De viser deler av det du gjør i VS Code, i én og samme celle.
ExerciseTre måter å importere
Gjør tre ting med modulen math: hent hele modulen og regn ut kvadratroten av \(16\) i a med math.sqrt, hent bare sqrt og regn ut det samme i b, og hent pi under navnet tall_pi.
Skriv import math, from math import sqrt og from math import pi as tall_pi. Bruk dem hver for seg.
ExerciseEn modul med demo
Lag funksjonene kvadrat(x) og kube(x), og en demo som bare kjøres når fila kjøres direkte: den skal skrive ut kvadrat(3) og kube(2), ett på hver linje.
Skriv if __name__ == "__main__": nederst, og skriv ut de to verdiene under.
Gjør det på maskinen
ExerciseEn kalkulator i flere filer
Lag et program der regnefunksjonene ligger i en egen modul.
Lag mappa kalkulator og åpne den i VS Code.
Lag regning.py med funksjonene pluss(a, b), minus(a, b) og gange(a, b).
Legg inn if __name__ == "__main__": nederst i regning.py, med et par utskrifter som tester funksjonene. Kjør fila og se at testene kjører.
Lag main.py som importerer funksjonene (bruk from regning import ...) og skriver ut pluss(2, 3) og gange(4, 5).
Kjør main.py. Kjører testene fra regning.py også? Hvorfor, eller hvorfor ikke?
AnswerFasit
regning.py:
def pluss(a, b):return a + bdef minus(a, b):return a - bdef gange(a, b):return a * bif__name__=="__main__":print(pluss(1, 1))print(gange(2, 3))
main.py:
from regning import pluss, gangeprint(pluss(2, 3))print(gange(4, 5))
Utskriften fra main.py er 5 og 20. Testene i regning.py kjører ikke når du importerer, siden __name__ da er "regning" og ikke "__main__". Kjører du regning.py direkte, skrives testene ut.
ExerciseSkyggefilen
Lag en mappe med fila random.py som inneholder def terning(): return 4.
Lag main.py som skriver import random og print(random.randint(1, 6)). Kjør den og les feilmeldingen.
Gi random.py et annet navn, slett mappa __pycache__, og kjør main.py igjen.
AnswerFasit
Første kjøring gir en AttributeError som sier at modulen random ikke har randint. Python importerte din egen random.py i stedet for standardmodulen. Etter at du har gitt fila et annet navn (for eksempel terning.py) og slettet __pycache__, importeres standardmodulen, og main.py skriver ut et tilfeldig tall fra \(1\) til \(6\).
Utfordringer
ExerciseTo filer som bruker hverandre
a.py har from b import fra_b, og b.py har from a import fra_a. Hva skjer når du kjører a.py, og hva kan du gjøre?
HintHint
Prøv det i VS Code. Les hele feilmeldingen.
AnswerFasit
Du får en ImportError om at navnet ikke kan importeres fordi modulen er delvis initialisert (en sirkulær import). a begynner å importere b, som begynner å importere a, som ikke er ferdig lastet ennå. Løsningen er å dele opp koden slik at avhengigheten går én vei: legg det de to modulene deler, i en tredje modul (felles.py) som begge importerer, eller flytt funksjonen inn i den ene modulen.
ExerciseHvor mange filer?
Et spill har kode for spilleren, fiendene og poengtelling. Foreslå hvordan du ville delt det i moduler, og hva som skulle stå i hver.
AnswerFasit
En fornuftig deling: spiller.py (alt om spilleren), fiender.py (fiendene), poeng.py (poengtelling) og main.py (spillløkka, som importerer de andre og setter dem sammen). Hver modul har ett ansvar, så det er lett å finne igjen koden, og du kan endre én del uten å røre de andre. Moduler som bare definerer funksjoner og konstanter, kan gjenbrukes i neste spill.
Oppsummering
Importere
import geometrifrom geometri import arealfrom geometri import areal as a
Kjøres eller importeres
if__name__=="__main__":print("kjørt direkte")
En modul
prosjekt/
├── main.py
└── geometri.py
Importer uten .py, og legg alle imports øverst.
Kode som gjør noe, hører under if __name__ == "__main__":.
Gi aldri en fil samme navn som en standardmodul.
3.2.2 Lage et eget bibliotek
Har du skrevet en nyttig funksjon, for eksempel gjennomsnitt, vil du bruke den igjen i neste prosjekt. Kopierer du den inn hver gang, har du plutselig mange versjoner, og retter du en feil, må du rette den alle steder. Løsningen er å samle slike funksjoner i et eget bibliotek: en mappe med moduler som du kan bruke i alle prosjektene dine. Det er akkurat slik math og statistics er laget.
Dette delkapittelet gjør du i VS Code.
Læringsmål
Etter dette delkapittelet skal du kunne
lage en pakke: en mappe med flere moduler og en __init__.py,
importere fra en pakke og fra moduler inni den,
organisere et bibliotek slik at det er lett å bruke og å vedlikeholde,
dokumentere biblioteket med docstrings.
Fra en modul til en pakke
Når du har flere moduler som hører sammen, legger du dem i en mappe. En mappe med moduler og en fil __init__.py kalles en pakke. Her er et lite bibliotek geometri for areal og omkrets, og et program som bruker det:
"""Areal av enkle figurer."""PI =3.14159def sirkelareal(r):"""Gir arealet av en sirkel."""return PI * r **2def rektangelareal(bredde, hoyde):"""Gir arealet av et rektangel."""return bredde * hoyde
geometri/omkrets.py:
from geometri.former import PIdef sirkelomkrets(r):return2* PI * r
Fila __init__.py kjøres når pakken importeres. Den kan være tom, men her bruker vi den til å gjøre de viktigste funksjonene lette å nå:
from geometri.former import sirkelareal, rektangelareal
Nå kan programmet bruk.py hente funksjonene på to måter:
geometri.sirkelareal virker fordi __init__.py har hentet funksjonen inn i pakken. sirkelomkrets ligger i en egen modul, så den importerer vi med hele stien: geometri.omkrets.
DefinisjonPakke og bibliotek
En modul er én .py-fil.
En pakke er en mappe med moduler og en fil __init__.py.
Et bibliotek er en samling kode som er laget for å brukes av andre programmer. Det er ofte en pakke.
Import med punktum følger mappestrukturen: from geometri.omkrets import sirkelomkrets betyr «fra mappa geometri, fila omkrets.py, hent sirkelomkrets».
Pakken må ligge der Python finner den: i samme mappe som programmet som bruker den (slik som over), eller installert i det virtuelle miljøet. Vil du bruke biblioteket i et annet prosjekt, kopierer du mappa dit. Vil du dele det med andre, kan du legge det i et eget GitHub-repo (se 1.4.1).
EksempelHvilken import hører til hvilken fil?
Strukturen er den samme som over. Skriv importene som henter
rektangelareal fra former.py
sirkelomkrets fra omkrets.py
hele pakken geometri
HintHint
Følg mappe- og filnavnene med punktum mellom.
LosningLøsning
from geometri.former import rektangelareal
from geometri.omkrets import sirkelomkrets
import geometri. Da bruker du de funksjonene __init__.py har hentet inn, som geometri.sirkelareal(2).
Et bibliotek du kan stole på
Et godt bibliotek er lett å bruke og lett å stole på. Noen vaner gjør stor forskjell:
RegelEt godt bibliotek
Ett ansvar per modul.statistikk.py regner statistikk, tekst.py jobber med tekst.
Gode navn. Funksjonene sier hva de gjør: median, ikke m eller beregn.
Dokumentasjon. Hver funksjon har en docstring (se 3.1.2), og hver modul har en kort docstring øverst.
Ingen overraskelser ved import. Moduler definerer bare funksjoner og konstanter, ikke noe som skriver ut eller spør brukeren.
Generelle funksjoner. De tar inn det de trenger som parametere, i stedet for å bruke tall som står inni funksjonen (se 3.4.1).
Test mens du bygger. Prøv funksjonene i en if __name__ == "__main__":-blokk med kjente svar.
Her er en liten modul statistikk.py med dokumentasjon, og en blokk som prøver funksjonene:
"""Enkel statistikk på lister med tall."""def snitt(tall):"""Gir gjennomsnittet av tallene."""returnsum(tall) /len(tall)def variasjonsbredde(tall):"""Gir største minus minste tall."""returnmax(tall) -min(tall)if__name__=="__main__":assert snitt([2, 4, 6]) ==4assert variasjonsbredde([3, 9, 5]) ==6print("Alle prøvene gikk bra")
assert stopper programmet med en feilmelding hvis påstanden er usann. Det er en enkel måte å teste at funksjonene gir de svarene du forventer. I kapittel 4 lærer du å teste mer systematisk.
EksempelHva mangler i modulen?
Se på statistikk.py. Hva ville du forbedret for at andre lettere skulle bruke den?
HintHint
Se på punktene i regelen over: navn, dokumentasjon, parametere, tomme lister.
LosningLøsning
Funksjonene har gode navn og docstrings, og modulen definerer bare funksjoner, så den er et godt utgangspunkt. Men snitt([]) og variasjonsbredde([]) ville gitt en feilmelding (deling på \(0\) og max av en tom liste). Biblioteket bør enten gi en tydelig feilmelding eller returnere None, og si hva den gjør i docstringen. Typehint (se 3.1.2) ville også gjort det tydeligere hva funksjonene tar inn.
AdvarselVanlige feil
Mappa mangler __init__.py. Moderne Python godtar ofte det, men la den være med: da er det klart at mappa er en pakke.
Du importerer med feil sti: from former import sirkelareal i stedet for from geometri.former import sirkelareal.
Du kjører en fil inne i pakken direkte, og importene i den feiler. Kjør hovedprogrammet utenfor pakken, ikke filene inni.
Pakken ligger ikke ved siden av programmet, så Python finner den ikke.
Funksjoner uten docstring. Om to uker husker du ikke hva de gjør.
Navn som kolliderer med standardbiblioteket, som en mappe som heter random eller test.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseModul, pakke og bibliotek
Forklar forskjellen på en modul, en pakke og et bibliotek. Gi et eksempel fra Python-installasjonen din.
HintHint
Én fil, en mappe med filer, og en samling kode som er laget for å brukes av andre.
AnswerFasit
En modul er én .py-fil, for eksempel random.py. En pakke er en mappe med moduler og en __init__.py, for eksempel pakken collections. Et bibliotek er en samling kode laget for å brukes av andre programmer, ofte en pakke. Standardbiblioteket er et bibliotek, og math er en modul i det.
funksjonen store_bokstaver fra tekst.py, med navnet stor
HintHint
Mappenavnet først, så filnavnet, så funksjonen.
AnswerFasit
from tallverktoy.tekst import store_bokstaver as stor
Nivå 2
ExerciseFinn feilen: pakken finnes ikke
bruk.py ligger i prosjekt/, og biblioteket i prosjekt/geometri/. Du får ModuleNotFoundError: No module named 'former' fra denne linja:
from former import sirkelareal
Forklar feilen og rett den.
HintHint
former.py ligger inni mappa geometri.
AnswerFasit
Modulen former ligger inni pakken geometri, ikke ved siden av bruk.py. Importen må ta med pakkenavnet: from geometri.former import sirkelareal.
ExerciseHva hører hjemme hvor?
Du lager et bibliotek tekstverktoy. Fordel disse funksjonene på moduler, og begrunn: antall_ord, snu_tekst, er_palindrom, snitt_ordlengde, snitt.
HintHint
Tenk på hva funksjonene jobber med: tekst eller tall.
AnswerFasit
De fire første jobber med tekst, så de hører i tekst.py (eventuelt delt i tegn.py for snu_tekst/er_palindrom og ord.py for antall_ord/snitt_ordlengde). snitt jobber med tall og passer bedre i en statistikk.py. Prinsippet er ett ansvar per modul: da vet du hvor du skal lete, og du kan bruke hver modul uten å dra med deg det du ikke trenger.
Kodeoppgaver
Disse oppgavene rettes automatisk. Du skriver funksjoner som kunne stått i et eget bibliotek, med docstring.
ExerciseMedianen
Lag funksjonen median(tall) som gir medianen: det midterste tallet når lista er sortert, eller gjennomsnittet av de to midterste hvis det er et partall antall.
Sorter med sorted(tall). Er antallet oddetall, er svaret på plass len // 2. Er det partall, bruker du plassene len // 2 - 1 og len // 2.
ExerciseVariasjonsbredde med docstring
Lag funksjonen variasjonsbredde(tall), som gir forskjellen på det største og det minste tallet, med en docstring.
max(tall) - min(tall). Husk docstringen først i funksjonen.
ExerciseTrygt snitt
Lag funksjonen snitt(tall) som gir gjennomsnittet, men None for en tom liste. Bruk typehint og en docstring.
Sjekk først om lista er tom. Typehintet på returverdien er float | None.
Gjør det på maskinen
ExerciseDitt første bibliotek
Lag biblioteket tallverktoy og bruk det fra et eget program.
Lag mappa bibliotek_prosjekt og åpne den i VS Code. Lag undermappa tallverktoy med en tom __init__.py.
Lag tallverktoy/statistikk.py med funksjonene snitt, median og variasjonsbredde. Gi hver funksjon en docstring og typehint, og modulen en docstring øverst.
Legg en blokk med assert under if __name__ == "__main__": i modulen, og kjør modulen for å teste funksjonene.
Lag bruk.py utenfor tallverktoy. Importer funksjonene og skriv ut statistikken for lista [4, 8, 15, 16, 23, 42].
Legg til en ny modul tekst.py med funksjonen antall_ord(tekst). Importer den i bruk.py og bruk den.
from tallverktoy.statistikk import snitt, medianfrom tallverktoy.tekst import antall_ordtall = [4, 8, 15, 16, 23, 42]print(snitt(tall))print(median(tall))print(antall_ord("alle gode ting er tre"))
Utskriften er 18.0, 15.5 og 5. Hver modul har én oppgave, og funksjonene har docstring og typehint. Testene med assert står under if __name__ == "__main__": og kjører bare når du kjører modulen direkte.
ExerciseBruk biblioteket i et annet prosjekt
Kopier mappa tallverktoy inn i en helt ny prosjektmappe, og lag et lite program som bruker den. Virker det uten at du endrer noe i biblioteket?
AnswerFasit
Ja. Siden biblioteket bare består av funksjoner og ikke avhenger av noe i det gamle prosjektet, virker det i det nye programmet med én importlinje. Det er poenget: du har skrevet koden én gang og bruker den overalt. Rettet du en feil i biblioteket etterpå, måtte du kopiere den rettede mappa til hvert prosjekt. Derfor er det lurt å ha biblioteket i ett eget Git-repo, så du alltid vet hvilken versjon som er den nyeste.
Utfordringer
ExerciseHva gjør init.py?
Prøv å la tallverktoy/__init__.py være tom, og så å skrive from tallverktoy.statistikk import snitt i __init__.py. Hva er forskjellen når du bruker biblioteket fra bruk.py?
AnswerFasit
Er __init__.py tom, må du bruke hele stien: from tallverktoy.statistikk import snitt. Har __init__.py importen, blir snitt en del av selve pakken, og du kan skrive from tallverktoy import snitt eller import tallverktoy og tallverktoy.snitt(...). Slik gjør __init__.py det enklere for brukeren, siden de ikke trenger å vite hvilken modul funksjonen ligger i.
ExerciseHva ville du dokumentert?
Du leverer biblioteket tallverktoy til en venn. Hva bør de få vite, utenom docstringene i koden?
AnswerFasit
En kort beskrivelse av hva biblioteket gjør, hvordan det brukes (et lite eksempel), hvilke funksjoner det har, hvilken Python-versjon det krever, og hva det gjør i spesielle tilfeller (som en tom liste). Det skrives gjerne i en README.md i mappa. Mer om det i kapittel 11.
Ett ansvar per modul, gode navn og docstring på alt.
Moduler definerer ting. De gjør ikke noe når de importeres.
Pakken må ligge der programmet kan finne den.
3.3 Standardbiblioteket og tredjepartspakker
Mye av koden du trenger, er skrevet av andre. Her ser du på det Python har med seg, og på pakker du kan installere.
3.3.1 Standardbiblioteket
Skal du regne ut kvadratroten av et tall, kaste en terning eller finne ut hvor mange dager det er til sommerferien, trenger du ikke skrive koden selv. Python har et standardbibliotek med hundrevis av ferdige moduler som følger med installasjonen. De fleste problemer du møter, har noen alt løst der. Det kalles at Python har «batteriene inkludert».
import mathprint(math.sqrt(16))print(math.pi)
4.0
3.141592653589793
Her bruker vi math til å finne kvadratroten av \(16\) og tallet \(\pi\). I dette delkapittelet ser du på de modulene du får mest bruk for, og hvordan du finner ut hva som finnes.
Læringsmål
Etter dette delkapittelet skal du kunne
bruke math, random, statistics, collections og datetime til vanlige oppgaver,
finne ut hva en modul og en funksjon gjør med dir() og help(), også uten nett,
bruke random.seed for å få de samme «tilfeldige» tallene hver gang du tester,
velge en ferdig funksjon framfor å skrive den selv.
math: matematikk
math har funksjoner for kvadratrot, avrunding, trigonometri og mer, og konstanter som pi.
ceil runder opp, floor runder ned, og gcd gir største felles faktor. isclose svarer på noe du møtte i 2.1.2: den sammenligner desimaltall med litt slingringsmonn, så 0.1 + 0.2 regnes som lik 0.3, selv om datamaskinen lagrer dem litt unøyaktig.
randint(1, 6) gir et helt tall fra \(1\) til \(6\), og begge endene er med. choice plukker et tilfeldig element fra en liste. Andre nyttige funksjoner er random.shuffle(liste) (blander lista på plass) og random.sample(liste, k) (plukker k ulike elementer).
Tilfeldige tall er vanskelige å teste, siden svaret er nytt hver gang. Derfor kan du så et frø (på engelsk seed) med random.seed(...). Da starter tallrekka på samme sted, og du får de samme «tilfeldige» tallene hver gang:
De to første tallene er de samme som de to siste. Tallene du får, kan være andre på din maskin, men de to første vil alltid være like de to siste. Fjern seed når programmet skal gi ekte tilfeldige tall.
EksempelTerningkast
Lag en funksjon kast_terning() som gir et tilfeldig tall fra \(1\) til \(6\), og bruk den til å kaste to terninger og regne ut summen.
HintHint
random.randint(1, 6) gir et tilfeldig tall fra \(1\) til \(6\).
LosningLøsning
import randomdef kast_terning():"""Gir et tilfeldig tall fra 1 til 6."""return random.randint(1, 6)summen = kast_terning() + kast_terning()print(summen)
Summen er et tall fra \(2\) til \(12\). Siden vi har pakket kastet inn i en funksjon, kan vi bruke det mange steder.
statistics og collections: tall og telling
statistics regner ut vanlige størrelser i statistikk:
mean er gjennomsnittet, median er midterste verdi, og stdev er standardavviket. Disse har du laget selv i 3.2.2, men her har du dem ferdig, og de er grundig testet.
collections.Counter teller hvor mange ganger hver verdi forekommer:
from collections import Counterantall = Counter("banana")print(antall)print(antall.most_common(1))
Counter({'a': 3, 'n': 2, 'b': 1})
[('a', 3)]
Counter("banana") gir en slags ordbok med a tre ganger, n to ganger og b én gang. most_common(1) gir det vanligste. Sammenlign med oppgaven du løste med en vanlig ordbok i 2.3.2: Counter gjør hele jobben på én linje.
datetime: dato og tid
Datoer er tungvint å regne med selv (måneder har ulik lengde, og det finnes skuddår). datetime gjør det for deg:
date(2026, 11, 18) lager en dato. Du kan legge til en timedelta (en tidsforskjell) og trekke to datoer fra hverandre, og da får du antall dager. strftime gir datoen i et format du bestemmer: %d er dag, %m er måned og %Y er år.
EksempelDager til ferien
Hvor mange dager er det fra \(18\). november \(2026\) til \(18\). juni \(2027\), og hvilken dato er \(100\) dager etter \(18\). november?
HintHint
Trekk to date-objekter fra hverandre, og legg til en timedelta(days=100).
Det er \(212\) dager, og \(100\) dager etter er datoen \(26\). februar \(2027\). Skuddår og månedslengder tar datetime seg av.
Finn ut hva som finnes
Standardbiblioteket er stort, og du kan ikke huske alt. På eksamen har du ikke nett, så du må kunne slå opp i Python selv. Det gjør du med dir() og help():
import mathprint([n for n indir(math) if n.startswith("s")])
['sin', 'sinh', 'sqrt', 'sumprod']
dir(math) lister alt som finnes i modulen. Her filtrerer vi på navn som starter med s. Vil du vite hva en funksjon gjør, bruker du help:
help(math.gcd)
Help on built-in function gcd in module math:

gcd(*integers)
    Greatest Common Divisor.
På nettet finner du den fullstendige dokumentasjonen på docs.python.org. Men også uten nett kommer du langt med dir og help.
RegelFør du skriver det selv
Før du skriver en funksjon, spør: finnes den allerede? Standardbiblioteket har sannsynligvis en løsning som er raskere, grundigere testet og dokumentert. Bruk dir() og help() til å lete. Skriv bare koden selv hvis du trenger noe spesielt, eller hvis oppgaven ber deg lære hvordan det virker.
AdvarselVanlige feil
Du glemmer å importere modulen: NameError: name 'math' is not defined.
Du gir en egen fil samme navn som en standardmodul (random.py), og får AttributeError.
random.randint(1, 6) har begge endene med. Det er ulikt range(1, 6), som stopper før \(6\).
Du blander modulen datetime med klassen datetime.datetime. Bruk from datetime import date for datoer.
Du sammenligner desimaltall med ==. Bruk math.isclose.
Du bruker random uten seed når du skal teste, og får nye tall hver gang.
Du skriver koden selv når den finnes i standardbiblioteket.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHva gir funksjonene?
Hva er verdien av uttrykkene? Alle krever import math.
math.ceil(4.2)
math.floor(4.8)
math.sqrt(49)
math.gcd(20, 30)
ExerciseHvilken modul?
Hvilken modul og funksjon (eller klasse) bruker du til å
trekke et tilfeldig navn fra en liste?
HintHint
Se på delene tidligere i delkapittelet.
AnswerFasit
random.choice(liste)
regne ut medianen av noen tall?
HintHint
Se på delene tidligere i delkapittelet.
AnswerFasit
statistics.median(tall)
telle hvor mange ganger hvert ord forekommer?
HintHint
Se på delene tidligere i delkapittelet.
AnswerFasit
collections.Counter(...) på lista med ord
finne ut hvor mange dager det er mellom to datoer?
HintHint
Se på delene tidligere i delkapittelet.
AnswerFasit
datetime: trekk den ene date fra den andre og bruk .days.
Nivå 2
ExerciseFinn feilen: terningen
Programmet skal kaste en terning, men gir en feilmelding.
print(random.randint(1, 6))
Hva er feilmeldingen, og hvorfor?
HintHint
Hva må du gjøre før du kan bruke en modul?
AnswerFasit
NameError: name 'random' is not defined. Modulen er ikke importert.
Rett programmet.
HintHint
Hva må du gjøre før du kan bruke en modul?
AnswerFasit
Legg til import random først i fila.
ExerciseHvor mange mulige verdier?
Hvor mange ulike verdier kan random.randint(1, 6) gi, og hvor mange kan random.choice(range(1, 6)) gi? Forklar forskjellen.
HintHint
Er endepunktene med i randint? Er de med i range?
AnswerFasit
randint(1, 6) kan gi \(6\) ulike verdier (tallene \(1\) til \(6\)), siden begge endene er med. range(1, 6) stopper før \(6\) og har bare tallene \(1\) til \(5\), så choice(range(1, 6)) kan bare gi \(5\) ulike verdier. Det er en vanlig feil å tro at randint er som range.
Kodeoppgaver
Disse oppgavene rettes automatisk. Standardbiblioteket er tilgjengelig i nettleseren.
ExerciseHypotenusen
Lag funksjonen hypotenus(a, b) som gir lengden av hypotenusen i en rettvinklet trekant med katetene a og b. Bruk math.sqrt.
Skriv import math og returner math.sqrt(a ** 2 + b ** 2).
ExerciseTerning
Lag funksjonen terning() som gir et tilfeldig tall fra \(1\) til \(6\).
Skriv import random og returner random.randint(1, 6).
ExerciseMest brukte ord
Lag funksjonen vanligste(tekst) som gir ordet som forekommer flest ganger i teksten. Bruk Counter fra collections.
Counter(tekst.split()).most_common(1) gir en liste med ett par (ord, antall). Hent ordet med [0][0].
ExerciseDager mellom to datoer
Lag funksjonen dager_mellom(a, b) som gir antall dager fra dato a til dato b. Datoene er tekster på formen "2026-11-18". Bruk date.fromisoformat.
date.fromisoformat("2026-11-18") lager en dato. Trekk dem fra hverandre og bruk .days.
ExerciseFinn feilen: glemt import
Programmet skal skrive ut kvadratroten av \(16\), men gir en feilmelding. Rett det.
Skriv from math import sqrt før print.
Utfordringer
ExerciseGjennomsnitt og median
Lag funksjonen sammendrag(tall) som gir gjennomsnittet og medianen som et tuppel (snitt, median). Bruk statistics.
statistics.mean og statistics.median. Returner dem som mean(tall), median(tall).
ExerciseHva gjør funksjonen?
Du har aldri hørt om funksjonen math.comb. Hvordan finner du ut hva den gjør, uten å søke på nettet? Prøv det.
KodeKjør koden i Python
AnswerFasit
Du bruker help(math.comb). Hjelpeteksten sier at funksjonen gir antall måter å velge k elementer blant n på, uten å ta hensyn til rekkefølgen (binomialkoeffisienten). math.comb(5, 2) er \(10\): det er ti måter å velge to elementer blant fem. Med dir(math) kunne du funnet navnet comb i første omgang.
Oppsummering
math
import mathmath.sqrt(x) math.pimath.ceil(x) math.floor(x)math.isclose(a, b)
randint(1, 6) har begge endene med. range(1, 6) stopper før \(6\).
Bruk seed når du tester kode med tilfeldighet.
Sjekk om funksjonen finnes i standardbiblioteket før du skriver den selv.
3.3.2 Tredjepartspakker
Standardbiblioteket har mye, men ikke alt. Skal du tegne en graf, lese en Excel-fil, lage et spill eller hente data fra nettet, trenger du noe mer. Da bruker du tredjepartspakker: pakker som andre har laget, og som ligger på nettstedet PyPI. «Tredjepart» betyr at de verken er skrevet av deg (første part) eller av Python-teamet (andre part). Det finnes over en halv million pakker, og dette er de du kommer til å bruke i IT2:
matplotlib for å tegne grafer,
pandas for å jobbe med tabeller og datasett,
requests for å hente data fra nettet,
pygame for å lage spill,
pytest for å teste kode.
Dette delkapittelet gjør du i VS Code, siden pakkene må installeres på maskinen din.
Læringsmål
Etter dette delkapittelet skal du kunne
forklare forskjellen på standardbiblioteket og tredjepartspakker,
installere en pakke i et virtuelt miljø og bruke den,
lese et kort eksempel i dokumentasjonen og tilpasse det,
vurdere om en pakke er til å stole på,
finne ut hva en pakke kan uten nett.
Installere og bruke en pakke
Du installerer pakker med pip, i det virtuelle miljøet for prosjektet (se 1.3.1). Her er en enkel figur med matplotlib. Først installerer du pakken, med miljøet aktivert:
pip install matplotlib
Så kan du tegne en graf:
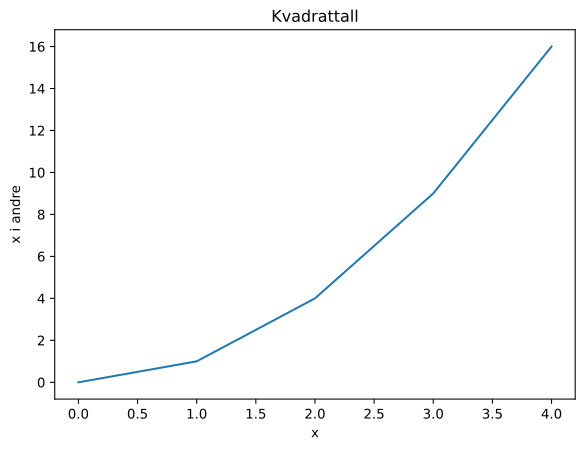
import matplotlib.pyplot as pltx = [0, 1, 2, 3, 4]y = [v **2for v in x]plt.plot(x, y)plt.xlabel("x")plt.ylabel("x i andre")plt.title("Kvadrattall")plt.show()
Koden henter pyplot-delen av matplotlib og gir den det vanlige kortnavnet plt. Så lager den to lister, tegner dem som en kurve, og setter navn på aksene og figuren. I VS Code åpnes figuren i et eget vindu når du kjører programmet.
Slik gjør du det hver gang du skal bruke en ny pakke:
RegelSlik bruker du en ny pakke
Finn den. Søk på pypi.org, eller bruk en du har fått anbefalt.
Les. Les beskrivelsen og eksemplet på pakkens side («Quickstart» eller «Getting started»).
Installer. Aktiver det virtuelle miljøet og kjør pip install navn.
Importer. Bruk navnet og kortnavnet dokumentasjonen foreslår.
Kjør et minimalt eksempel. Få det aller enkleste til å virke først, og bygg videre derfra.
Lagre den. Kjør pip freeze > requirements.txt så andre og framtidige du kan installere det samme.
Mange pakker har et vanlig kortnavn, som du bør bruke slik at koden din ligner på alle andre: import numpy as np, import pandas as pd, import matplotlib.pyplot as plt.
EksempelTegn en linje
Bruk matplotlib til å tegne en rett linje gjennom punktene \((0, 1)\) og \((4, 9)\).
HintHint
plt.plot(x_verdier, y_verdier) tegner kurven. Du trenger to lister: én med \(x\)-verdiene og én med \(y\)-verdiene.
LosningLøsning
import matplotlib.pyplot as pltplt.plot([0, 4], [1, 9])plt.show()
Funksjonen får først alle \(x\)-verdiene og så alle \(y\)-verdiene. Linja går fra punktet \((0, 1)\) til \((4, 9)\).
Er pakken til å stole på?
Hvem som helst kan legge en pakke ut på PyPI, og når du installerer den, kjører du kode du ikke har skrevet selv. Da bør du være litt på vakt. Før du bruker en ukjent pakke, sjekk:
Er den populær? Mange nedlastinger og stjerner på GitHub er et godt tegn.
Er den vedlikeholdt? Se når siste versjon kom ut. En pakke som ikke er oppdatert på mange år, kan ha feil som aldri blir rettet.
Har den dokumentasjon? God dokumentasjon er et tegn på en seriøs pakke.
Hvilken lisens har den? Lisensen bestemmer hva du har lov til å bruke den til.
Skriver du navnet riktig? Noen lager pakker med navn som ligner på kjente (reqeusts i stedet for requests) for å lure folk til å installere skadelig kode. Kopier navnet fra dokumentasjonen.
I IT2 bruker vi velkjente pakker, så du trenger ikke tenke på dette hver dag. Men det er en vane som vil bety mye hvis du programmerer i arbeidslivet.
EksempelKan du stole på pakken?
Du finner pakken lynraske-grafer på PyPI. Den har 12 nedlastinger, den siste versjonen kom for fire år siden, og den har ingen dokumentasjon. Pakken du alternativt ville brukt, heter matplotlib. Hvilken velger du, og hvorfor?
HintHint
Se på popularitet, vedlikehold og dokumentasjon.
LosningLøsning
matplotlib. Den har millioner av brukere, oppdateres jevnlig og har omfattende dokumentasjon. lynraske-grafer har nesten ingen brukere, er ikke vedlikeholdt og er ikke dokumentert. Du risikerer feil som ingen retter, og i verste fall skadelig kode. Det kan være gode grunner til å bruke en ukjent pakke, men da bør du lese koden først.
Uten nett
På eksamen har du ikke nett. Pakkene må derfor være installert på forhånd (se 1.3.1), og du må kunne slå opp uten dokumentasjonssiden. Det gjør du som for standardbiblioteket:
import matplotlib.pyplot as plthelp(plt.plot)print([n for n indir(plt) if n.startswith("sub")])
help(plt.plot) viser dokumentasjonen til funksjonen, og dir(plt) lister hva modulen har. Mange pakker har gode docstrings, nettopp slik som du lærte å skrive i 3.1.2. Du kan også spørre pip om en pakke er installert og hvilken versjon:
pip show matplotlib
AdvarselVanlige feil
ModuleNotFoundError: pakken er ikke installert i miljøet du kjører fra. Aktiver miljøet og installer på nytt, og sjekk tolken i VS Code (se 1.3.1).
Du installerer med feil navn. Navnet du installerer med, er ikke alltid det du importerer (pip install scikit-learn, men import sklearn).
Du glemmer å installere pakken før eksamen.
Du installerer en pakke med et navn som ligner, men som ikke er den riktige.
Du kopierer et eksempel uten å forstå det. Prøv å endre tallene og se hva som skjer.
Du tar ikke vare på listen over pakker i requirements.txt.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseStandardbibliotek eller pakke?
Hvilke av disse må du installere med pip, og hvilke følger med Python?
math
matplotlib
random
pandas
datetime
HintHint
Standardbiblioteket følger med. De andre henter du fra PyPI.
AnswerFasit
math, random og datetime følger med Python (standardbiblioteket). matplotlib og pandas er tredjepartspakker og må installeres med pip install.
ExerciseHva gjør kommandoene?
Forklar hva hver kommando gjør.
pip install matplotlib
HintHint
Tre av dem gjøres i terminalen, og én i Python-koden.
AnswerFasit
Henter og installerer matplotlib fra PyPI (i miljøet som er aktivt).
pip show matplotlib
HintHint
Tre av dem gjøres i terminalen, og én i Python-koden.
AnswerFasit
Viser informasjon om den installerte pakken, blant annet versjon.
pip freeze > requirements.txt
HintHint
Tre av dem gjøres i terminalen, og én i Python-koden.
AnswerFasit
Skriver en liste over alle installerte pakker og versjoner til requirements.txt.
import matplotlib.pyplot as plt
HintHint
Tre av dem gjøres i terminalen, og én i Python-koden.
AnswerFasit
I Python-koden: henter pyplot fra matplotlib og gir den kortnavnet plt.
Nivå 2
ExerciseFinn årsaken
Programmet starter med import pandas as pd, men du får ModuleNotFoundError: No module named 'pandas'. Du er sikker på at du har installert pandas. Gi to mulige årsaker og forklar hvordan du sjekker dem.
HintHint
Pakken kan være installert et annet sted enn der programmet kjører.
AnswerFasit
Pakken er installert utenfor det virtuelle miljøet, eller i et annet miljø enn det programmet kjører i. Sjekk at (.venv) står i prompten, og kjør pip list for å se om pandas står der. (2) VS Code bruker en annen Python-tolk enn den i miljøet. Sjekk tolken nederst til høyre og velg den i .venv. Hjelper ingen av dem, installer på nytt med miljøet aktivert.
ExerciseVurder pakkene
Du skal lese en Excel-fil i Python og finner to pakker. Pakke A har 50 millioner nedlastinger i måneden, siste versjon kom for to uker siden, og den har god dokumentasjon. Pakke B har 200 nedlastinger, ingen oppdatering på tre år og bare en kort README. Hvilken velger du, og hva vil du sjekke før du bruker den?
AnswerFasit
Pakke A: den er populær, aktivt vedlikeholdt og godt dokumentert. Før du bruker den, bekrefter du at du har skrevet navnet riktig, ser gjennom dokumentasjonen og lisensen, og leser at den kan lese filtypen du trenger. Pakke B bør du bare velge hvis A ikke kan det du trenger, og da bør du lese koden og huske at feil kanskje aldri blir rettet.
Gjør det på maskinen
ExerciseDin første graf
Åpne en prosjektmappe i VS Code og aktiver det virtuelle miljøet (se 1.3.1).
Installer matplotlib med pip install matplotlib.
Lag graf.py som tegner grafen til \(y = x^2\) for \(x\) fra \(-3\) til \(3\), med \(x\)-verdiene \(-3, -2, \ldots, 3\).
Gi grafen en tittel og navn på aksene.
Kjør programmet, og lagre figuren som en fil med plt.savefig("graf.png") i stedet for plt.show().
Kjør pip freeze > requirements.txt og åpne fila.
AnswerFasit
import matplotlib.pyplot as pltx = [-3, -2, -1, 0, 1, 2, 3]y = [v **2for v in x]plt.plot(x, y)plt.title("y = x i andre")plt.xlabel("x")plt.ylabel("y")plt.savefig("graf.png")
Programmet lager fila graf.png i mappa. requirements.txt inneholder matplotlib med versjon, og pakkene den trenger, for eksempel numpy.
ExerciseTest uten nett
Sørg for at matplotlib, pandas, pytest, requests og pygame er installert i miljøet ditt.
Slå av nettet på maskinen.
Start Python (python i terminalen) og skriv import matplotlib, import pandas, og så videre for hver av pakkene. Bruk help(pandas.read_csv) til å slå opp hva funksjonen gjør.
Skriv ned hvilke av pakkene som feilet, og hva du må gjøre for at de virker neste gang.
AnswerFasit
Pakkene som er installert, importeres uten feil selv uten nett, og help(pandas.read_csv) viser dokumentasjonen. Mangler en pakke, får du ModuleNotFoundError: No module named '...', og du må installere den mens du har nett. Det er derfor du må installere alt før eksamen.
Utfordringer
ExerciseUtforsk en ny pakke
Velg en pakke du ikke har brukt, for eksempel colorama (farget tekst i terminalen) eller qrcode (lager QR-koder). Vurder om den er til å stole på, installer den og få et minimalt eksempel til å virke.
HintHint
Følg de seks trinnene i regelen om å bruke en ny pakke.
AnswerFasit
Et godt svar beskriver hvordan du vurderte pakken (nedlastinger, siste oppdatering, dokumentasjon, lisens), hvilken kommando du brukte for å installere den, og viser koden som virket. For colorama kan det være from colorama import Fore og print(Fore.RED + "Hei"). Det viktigste er at du kan forklare hva hver linje gjør.
ExerciseHvorfor ikke skrive alt selv?
Gi to fordeler og en ulempe ved å bruke tredjepartspakker i stedet for å skrive koden selv.
AnswerFasit
Fordeler: du sparer tid, og pakkene er som regel grundig testet og raskere enn det du rekker å lage. Du kan også bygge på det andre har lært. Ulemper: du er avhengig av andres kode som kan ha feil eller bli utdatert, du må installere og holde styr på versjoner, og du kjører kode du ikke har skrevet selv, noe som kan være en sikkerhetsrisiko hvis pakken ikke er til å stole på.
Oppsummering
Installere
pip install matplotlib
pip show matplotlib
pip list
Importere
import matplotlib.pyplot as pltimport pandas as pd
Tegne en graf
plt.plot(x, y)plt.title("Tittel")plt.show()
Slå opp uten nett
help(plt.plot)dir(plt)
Installer i det virtuelle miljøet, og lagre requirements.txt.
Sjekk at pakken er populær, vedlikeholdt og dokumentert.
Installer alle pakker du trenger, før eksamen.
3.4 Generalisering av løsninger
Kjernen i gjenbrukbar kode er å gjøre en løsning som virker for ett tilfelle, om til en som virker for mange. Her lærer du hvordan, og når det lønner seg.
3.4.1 Fra spesiell til generell løsning
Du skal skrive ut gangetabellen til \(7\). Det er lett:
for i inrange(1, 6):print(f"{i} x 7 = {i *7}")
1 x 7 = 7
2 x 7 = 14
3 x 7 = 21
4 x 7 = 28
5 x 7 = 35
Nå vil en venn ha gangetabellen til \(9\). Og en annen vil ha den til \(12\), men bare til \(3\). Skal du skrive et nytt program hver gang? Nei: tallet \(7\) og tallet \(5\) er spesielle verdier som står fast i koden. Gjør du dem om til parametere, har du en generell løsning som virker for alle:
def gangetabell(tall, til=10):"""Gir gangetabellen til tall."""return [f"{i} x {tall} = {i * tall}"for i inrange(1, til +1)]print(gangetabell(7, 3))print(gangetabell(9, 2))
['1 x 7 = 7', '2 x 7 = 14', '3 x 7 = 21']
['1 x 9 = 9', '2 x 9 = 18']
Å generalisere vil si å gjøre en løsning som virker for ett tilfelle, til en løsning som virker for mange. Det er kjernen i gjenbrukbar kode, og det du har jobbet mot i hele dette kapittelet.
Læringsmål
Etter dette delkapittelet skal du kunne
finne de spesielle verdiene i en løsning, og gjøre dem om til parametere,
trekke ut kode som gjentar seg, til en funksjon,
sende en funksjon inn i en annen funksjon som et argument,
vurdere når det lønner seg å generalisere, og når det er for tidlig,
teste en generell løsning med flere ulike verdier.
Tre steg fra spesiell til generell
Hvordan gjør du en spesiell løsning generell? Gå gjennom tre steg:
RegelTre steg
Finn det spesielle. Hvilke tall, tekster eller lister står fast i koden, men kunne vært noe annet?
Gjør dem om til parametere. Pakk koden inn i en funksjon, og la hver spesiell verdi bli en parameter. Gi fornuftige standardverdier der det passer.
Gi funksjonen et godt navn, og test den med flere verdier. Både vanlige verdier og spesielle (null, én, tom liste).
La oss prøve det. Programmet under skriver ut en tabell som gjør grader celsius om til fahrenheit:
for c inrange(0, 41, 10):print(c, c *9/5+32)
0 32.0
10 50.0
20 68.0
30 86.0
40 104.0
Her er flere ting spesielle: startverdien \(0\), sluttverdien \(40\) og steget \(10\). Vi gjør dem om til parametere, og lar funksjonen gi tilbake tabellen i stedet for å skrive den ut. Da kan den som kaller funksjonen, selv velge hva som skal skje med den:
def celsius_tabell(start=0, slutt=40, steg=10):"""Gir par (celsius, fahrenheit).""" rader = []for c inrange(start, slutt +1, steg): rader.append((c, c *9/5+32))return raderprint(celsius_tabell())print(celsius_tabell(-10, 10, 10))
Den første linja gir den opprinnelige tabellen med standardverdiene. Den andre viser at den samme funksjonen nå virker for et helt annet område.
EksempelGjør programmet generelt
Programmet regner ut hvor mange sekunder det er i \(3\) timer. Hva er spesielt, og hvordan gjør du det generelt?
print(3*60*60)
HintHint
Hvilket tall kunne vært noe annet? Pakk det inn i en funksjon.
LosningLøsning
Det spesielle er tallet \(3\) (antall timer). Vi gjør det til en parameter:
def timer_til_sekunder(timer):"""Gir sekunder i et antall timer."""return timer *60*60print(timer_til_sekunder(3))print(timer_til_sekunder(0.5))
10800
1800.0
Funksjonen virker nå for alle antall timer, også halve. Du kan generalisere videre med minutter og sekunder, men gjør det først når du trenger det.
Fjern kopiert kode
Det vanligste tegnet på at du trenger en funksjon, er at du kopierer og limer inn kode og endrer litt. Se på dette:
pris1 =100pris2 =250pris3 =80print(f"Pris 1 med mva: {pris1 *1.25}")print(f"Pris 2 med mva: {pris2 *1.25}")print(f"Pris 3 med mva: {pris3 *1.25}")
Pris 1 med mva: 125.0
Pris 2 med mva: 312.5
Pris 3 med mva: 100.0
Tre nesten like linjer. Skal du endre mva-satsen, må du rette tre steder, og er det lett å glemme ett. Trekker du felles kode ut i en funksjon, retter du ett sted:
def med_mva(pris, mva=25):"""Gir prisen med mva."""return pris * (100+ mva) /100for pris in [100, 250, 80]:print(f"Pris med mva: {med_mva(pris)}")
Pris med mva: 125.0
Pris med mva: 312.5
Pris med mva: 100.0
Dette kalles DRY-prinsippet (fra engelsk Don’t Repeat Yourself): hver kunnskap skal bare stå ett sted i koden. Kopierer du kode, har du kanskje en funksjon som ikke er laget ennå.
EksempelFinn gjentakelsen
Hva gjentar seg i koden, og hvordan trekker du den ut i en funksjon?
Ordet Hei og utropstegnet er like, bare navnet endrer seg. Vi lager en funksjon med navnet som parameter, og bruker en løkke:
def hils(navn):print(f"Hei {navn}!")for navn in ["Kari", "Ola", "Per"]: hils(navn)
Hei Kari!
Hei Ola!
Hei Per!
Skal du endre hilsenen, gjør du det ett sted.
Funksjoner som argumenter
Noen ganger er det som er spesielt, ikke et tall, men hva som skal gjøres. Se på to funksjoner som begge går gjennom en liste:
def antall_partall(tall): antall =0for x in tall:if x %2==0: antall +=1return antalldef antall_store(tall): antall =0for x in tall:if x >10: antall +=1return antall
De er nesten like. Bare betingelsen er forskjellig. Vi kan gjøre betingelsen om til en parameter ved å sende inn en funksjon:
def antall_som(tall, test):"""Teller tall som oppfyller testen.""" antall =0for x in tall:if test(x): antall +=1return antalldef er_partall(x):return x %2==0liste = [1, 2, 3, 4, 5, 6]store = [5, 12, 8, 20]print(antall_som(liste, er_partall))print(antall_som(store, lambda x: x >10))
3
2
I første kall sender vi inn en funksjon vi har navngitt. Merk at vi skriver er_partall uten parentes: da sender vi selve funksjonen, uten å kalle den. I andre kall bruker vi lambda, en kort måte å lage en liten funksjon uten navn: lambda x: x > 10 betyr «en funksjon som tar x og gir x > 10».
Nå virker antall_som for alle betingelser vi kan komme på, og vi trenger bare ett sted å rette koden.
EksempelNy test uten ny funksjon
Bruk antall_som til å telle hvor mange tekster i lista som er lengre enn \(3\) tegn.
HintHint
Du trenger en funksjon som tar en tekst og gir True hvis den er lengre enn \(3\).
Bare fire og seks har mer enn tre tegn, så svaret er \(2\). Vi trengte ingen ny funksjon, bare en ny test.
Ikke generaliser for tidlig
Man kan gå for langt. En funksjon med ti parametere som kan gjøre alt, er vanskelig å bruke og vanskelig å forstå. Noen tommelfingerregler:
Vent til du trenger det. Skriv den enkle løsningen først. Når du ser at du skal gjøre noe lignende en gang til, er det tid for å generalisere.
Regelen om tre. Første gang skriver du koden. Andre gang kopierer du kanskje. Tredje gang lager du en funksjon.
Bare det som varierer, blir parametere. Er noe alltid likt, trenger det ikke være en parameter.
Gi standardverdier til det vanlige. Da blir den vanlige bruken enkel, og de spesielle tilfellene er mulige.
Test med flere verdier. En generell funksjon må virke for mer enn det du laget den for: små, store, tomme og negative verdier.
I prosjektene bruker du dette direkte. I P1.3 rydder du opp i spillkoden ved å samle det som gjentar seg, i funksjoner og moduler, og i P3.4 lager du gjenbrukbare funksjoner til dataanalyse.
AdvarselVanlige feil
Funksjonen bruker en verdi som står utenfor, i stedet for en parameter. Da virker den bare i det ene programmet.
Funksjonen skriver ut i stedet for å gi tilbake svaret, så den kan ikke brukes videre.
Du generaliserer for tidlig og lager en funksjon med mange parametere som ingen forstår.
Du kopierer kode i stedet for å lage en funksjon.
Du tester bare med ett eksempel, og oppdager først senere at funksjonen feiler for tom liste eller negative tall.
Du sender funksjonen med parentes (er_partall()) i stedet for uten (er_partall).
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHva er spesielt?
Hvilke verdier er spesielle, og dermed gode kandidater til parametere, i hvert av disse programmene?
print("Arealet er", 3.14 * 5 ** 2)
HintHint
Se etter tall og tekster som lett kunne vært noe annet.
AnswerFasit
Radiusen \(5\) (og \(\pi\) kan være en konstant). Parameter: r.
for i in range(1, 11): print(i * i)
HintHint
Se etter tall og tekster som lett kunne vært noe annet.
AnswerFasit
Sluttverdien \(11\) (eller antallet \(10\)). Parameter: n.
print("God morgen, " + "Kari")
HintHint
Se etter tall og tekster som lett kunne vært noe annet.
AnswerFasit
Navnet "Kari". Parameter: navn. Hilsenen "God morgen, " kan også være en parameter med standardverdi.
ExerciseHvilken er mer generell?
Hvilken av de to funksjonene er mest generell, og hvorfor?
areal_b er mest generell. Den virker for alle rektangler, siden bredde og høyde er parametere. areal_a kan bare regne ut arealet til ett bestemt rektangel, \(3 \cdot 4\). Det spesielle (tallene) står fast inni funksjonen.
Nivå 2
ExerciseFinn feilen: funksjonen er ikke generell
Funksjonen skal gi gjennomsnittet av en liste, men virker bare for én bestemt liste.
Hvilken liste bruker funksjonen? Hvor kommer den fra?
AnswerFasit
Funksjonen bruker lista tall som står utenfor, i stedet for en parameter. Den virker bare for akkurat den lista, og hvis du endrer variabelen et annet sted, endres svaret uten at du ser det.
Rett funksjonen.
HintHint
Hvilken liste bruker funksjonen? Hvor kommer den fra?
AnswerFasit
La lista bli en parameter:
def snitt(tall):returnsum(tall) /len(tall)
def snitt(tall):returnsum(tall) /len(tall)
ExerciseSkriver ut eller gir tilbake?
Funksjonen under er ikke særlig gjenbrukbar. Forklar hvorfor, og rett den.
def kvadrat(x):print(x * x)y = kvadrat(4) +1
HintHint
Hva gir funksjonen tilbake? Hva er kvadrat(4)?
AnswerFasit
Funksjonen skriver ut, men gir ikke noe tilbake, så kvadrat(4) er None, og None + 1 gir en TypeError. En funksjon som gir tilbake en verdi, kan brukes i andre regnestykker, lagres, sammenlignes og skrives ut når vi vil. Rettet: return x * x.
Kodeoppgaver
Disse oppgavene rettes automatisk. Testene kaller funksjonen din med flere ulike verdier.
ExerciseFra tre linjer til én funksjon
Koden under skriver ut tre priser med mva, med nesten like linjer. Lag funksjonen med_mva(pris) som gir prisen med \(25\) % mva, og bruk den til å skrive ut de tre prisene, ett tall på hver linje.
Lag def med_mva(pris): som gir pris * 1.25. Bruk den i hver print.
ExerciseGangetabell
Lag funksjonen gangetabell(tall, til=10) som gir en liste med tekster på formen "1 x 7 = 7", fra \(1\) til og med til.
Lag en tom liste, og legg til f"{i} x {tall} = {i * tall}" for hver i fra \(1\) til til. Husk at range stopper før sluttverdien.
ExerciseFinn feilen: funksjonen er for spesiell
Funksjonen skal gi gjennomsnittet av en liste, men bruker en liste som står utenfor. Gjør den generell.
Skriv def snitt(tall): og bruk parameteren i stedet for lista utenfor.
ExerciseTell det du vil
Lag funksjonen antall_som(liste, test) som gir hvor mange elementer i lista som test gir True for.
Gå gjennom lista med en løkke. For hvert element kaller du test(element), og øker telleren hvis svaret er True.
Utfordringer
ExerciseFiltrer en liste
Lag funksjonen filtrer(liste, test) som gir en ny liste med bare de elementene test gir True for.
Lag en tom liste, og legg til elementet hvis test(element) er True.
ExerciseBruk funksjonen på alt
Du har lagd snitt(tall). Gi tre ulike situasjoner der du kan bruke den samme funksjonen, og forklar hvorfor det er en fordel.
AnswerFasit
Samme funksjon passer for gjennomsnittskarakter (en liste med karakterer), gjennomsnittstemperatur (en liste med målinger) og gjennomsnittspris (en liste med priser). Det er en fordel fordi du skriver og tester koden én gang, og rettelser og forbedringer gjelder alle stedene. Funksjonen vet ikke hva tallene betyr, og trenger ikke vite det. Slik er generelle funksjoner bygd.
Finn minst fire ting som bør forbedres, og forklar hvorfor.
HintHint
Se på standardverdien, variabelen utenfor funksjonen, navnene, dokumentasjonen og linja nederst.
AnswerFasit
liste=[] som standardverdi: den samme listen deles mellom alle kall. Bruk None. (2) Funksjonen endrer en global variabel (resultater), så den har skjulte bivirkninger og er vanskelig å teste. La den bare gi tilbake et resultat. (3) Funksjonen heter regn, og parametrene a og b sier ingenting. Bruk navn som forteller hva de gjør. (4) Ingen docstring eller typehint, så ingen vet hva den gjør. (5) print(regn(1, 2)) står utenfor if __name__ == "__main__":, så den kjører hver gang modulen importeres. (6) Funksjonen gjør to ting: legger til i lista og regner ut summen.
ExercisePris med rabatt
Lag funksjonen pris_med_rabatt(pris, antall=1, rabatt=0). Den gir prisen for antall varer med rabatt prosent rabatt, med typehint (float for pris og rabatt, int for antall, float ut) og en docstring.
Prisen er pris * antall * (100 - rabatt) / 100. Typehintet på antall er int, og de andre er float.
ExerciseOppsummer tall
Lag funksjonen oppsummer(tall, desimaler=2) som gir en ordbok med gjennomsnitt, median, minste og største tall. Snitt og median skal rundes til desimaler desimaler. Bruk statistics.
Bruk statistics.mean, statistics.median, min og max, og round(verdi, desimaler).
ExerciseFra spesielt til generelt
Programmet teller hvor mange e det er i en bestemt tekst. Lag funksjonen tell_tegn(tekst, tegn) som teller hvor mange ganger tegn forekommer i tekst, og bruk den til å skrive ut antall e i teksten.
Pakk løkka inn i en funksjon der tekst og tegn er parametere. Kall funksjonen med den opprinnelige teksten og tegnet "e" til slutt.
ExerciseBygg et verktøybibliotek
Samle funksjonene du har laget i et eget bibliotek, og bruk det fra et program.
Lag mappa verktoy_prosjekt og åpne den i VS Code, med et virtuelt miljø.
Lag pakken verktoy med modulene statistikk.py (snitt, median, oppsummer) og tekst.py (tell_tegn, antall_ord).
Gi alle funksjonene docstring og typehint, og hver modul en kort docstring øverst.
La __init__.py hente inn de viktigste funksjonene, slik at from verktoy import snitt virker.
Lag bruk.py utenfor pakken som bruker minst tre funksjoner fra biblioteket.
Legg til if __name__ == "__main__": med assert-prøver i hver modul. Kjør modulene.
Lag et Git-repo og lagre biblioteket i en commit. Husk .gitignore for .venv/.
Utskriften er 9, 11.5 og 3. Hver modul har ett ansvar, funksjonene er dokumentert og modulene gjør ingenting når de importeres. Prøvene med assert står under if __name__ == "__main__": og kjører bare når du kjører modulen direkte.
ExerciseHva bør bli hva?
Velg om du ville lagt dette i en funksjon, en modul eller en pakke, og begrunn.
Tre linjer som regner ut moms og som brukes fire steder i samme fil.
HintHint
Tenk på hvor mye kode det er, og hvor det skal brukes.
AnswerFasit
En funksjon: koden gjentar seg i samme fil, og én funksjon (med_mva) fjerner kopieringen.
Ti funksjoner for statistikk som du vil bruke i alle prosjektene dine.
HintHint
Tenk på hvor mye kode det er, og hvor det skal brukes.
AnswerFasit
En modul (statistikk.py): flere funksjoner som hører sammen og skal brukes i flere prosjekter.
En samling med fem moduler for geometri, tekst, tall, datoer og filer.
HintHint
Tenk på hvor mye kode det er, og hvor det skal brukes.
AnswerFasit
En pakke: flere moduler som hører til ett bibliotek, samlet i en mappe med __init__.py.