Data er det du ender opp med når noen har målt, talt eller registrert noe: temperaturer, karakterer, salgstall, reisetider. Verdien kommer først når du stiller et spørsmål til dataene og får et svar du kan stole på. Hvor mange bor i hver kommune? Har det blitt varmere? Hvilken butikk selger mest? Dette kapittelet handler om å gå fra en fil med rader og kolonner til et svar du kan vise fram.
Til jobben bruker vi pandas, det mest brukte Python-biblioteket for tabelldata. Du lærer å lese inn data fra CSV og JSON, å finne og rette feil og manglende verdier, å filtrere, sortere og regne ut nye kolonner, å beskrive data med statistikk og gruppering, å tegne diagrammer med matplotlib og å trekke en konklusjon som dataene faktisk støtter. Alt dette er kompetansemålet om å bruke programmering til å innhente, analysere og presentere informasjon fra reelle datasett.
Kapittelet bygger på kapittel 8, der du leste filer, og på kapittel 3, der du lærte å bruke biblioteker. pandas og matplotlib er ikke med i Python fra start. De må være installert i miljøet du jobber i (pip install pandas matplotlib, se Seksjon 1.3). Notatboka i nettleseren har dem klare.
Pass på på eksamen: På skriftlig eksamen har du ikke nettilgang, og dataene kommer som filer. Du må kunne lese dem inn, rydde og regne på dem uten å søke opp syntaksen. Bruk help(), dir(df) og df.info() for å finne ut hva du har. Installer pandas og matplotlib på maskinen du bruker til eksamen i god tid.
Notatboka har flere oppgaver, som rettes med sjekk(). Den kan brukes i nettleseren eller i VS Code. Oppgavene bruker små datasett som står som tekst i notatboka, så de virker uten filer og uten nett.
Læringsmål
Etter å ha arbeidet med kapittelet skal du kunne
lage og lese en DataFrame og en Series, og hente ut kolonner, rader og enkeltverdier,
lese inn CSV og JSON med pandas, og håndtere skilletegn, koding og overskrifter,
finne og håndtere manglende og feil data, og filtrere, sortere og lage nye kolonner,
beregne og tolke beskrivende statistikk, og gruppere data med groupby,
lage og tolke linjediagram, søylediagram, histogram og spredningsdiagram med matplotlib, og velge riktig diagram,
gå fra et spørsmål, via en analyse, til en konklusjon som dataene støtter, og si hva dataene ikke kan vise.
9.1 Innlesing av data
Før du kan analysere data, må du ha dem inn i Python, i en form du kan regne på. Denne seksjonen handler om tabellen som pandas bruker, DataFrame, og om hvordan du får data fra filer inn i den.
9.1.1 DataFrame og Series
Tenk deg et regneark med fem byer. Hver rad er en by, og kolonnene er navn, innbyggertall og areal. Vil du finne gjennomsnittlig areal, markerer du kolonnen og bruker en formel. Du bryr deg ikke om hver enkelt rad. Du tenker på kolonnen som én ting.
Med det vi kan fra før, kunne vi lagret byene som en liste av ordbøker og regnet ut snittet med en løkke. Det virker, men gir mye kode til hver lille utregning. pandas lar oss gjøre det som i regnearket: vi har en tabell, og vi regner på hele kolonner på én gang.
Læringsmål
Etter dette delkapittelet skal du kunne
lage en DataFrame av en ordbok med lister, og lese av form, kolonner og datatyper,
hente ut en kolonne som en Series, og regne med hele kolonnen på én gang,
hente ut flere kolonner, en rad og en enkeltverdi,
lage en ny kolonne av andre kolonner.
Tabellen: DataFrame
En DataFrame er en tabell med rader og kolonner. Alle verdiene i en kolonne har samme type, og hver kolonne har et navn. Den enkleste måten å lage en på er med en ordbok, der nøklene er kolonnenavn og verdiene er lister med like mange elementer:
(Tallene er avrundede, og arealet er i km².) import pandas as pd er en fast vane: alle bruker kortnavnet pd.
Tallene til venstre, \(0\) til \(4\), er indeksen. Den navngir radene, og pandas lager den selv når du ikke gir noen. Vi skal bruke den litt senere, men du trenger ikke tenke på den ennå.
Når du får en tabell du ikke kjenner, er det første du gjør å se på den. Disse tre egenskapene og metodene gir et raskt overblikk:
(5, 3)
['by', 'innbyggere', 'areal']
by              str
innbyggere    int64
areal         int64
dtype: object
shape er et par (antall rader, antall kolonner). columns er navnene på kolonnene. dtypes viser datatypen i hver kolonne: int64 er heltall, float64 er desimaltall, og tekst vises som object eller str, avhengig av versjonen av pandas. Er tabellen stor, viser byer.head() de første fem radene, og byer.info() gir en oppsummering med antall verdier og typer.
DefinisjonDataFrame
import pandas as pdtabell = pd.DataFrame({"kolonne1": [liste, ...],"kolonne2": [liste, ...],})
En DataFrame er en tabell med navngitte kolonner og en indeks som navngir radene. Alle listene må ha like mange elementer. tabell.shape gir (rader, kolonner), tabell.columns kolonnenavnene og tabell.dtypes datatypene.
EksempelLag en tabell over elever
Lag en DataFrameelever med kolonnene navn og poeng for Kari (\(45\)), Ola (\(38\)) og Mia (\(51\)). Hvor mange rader og kolonner har tabellen?
HintHint
Lag en ordbok der hver nøkkel er et kolonnenavn og hver verdi er en liste. elever.shape gir størrelsen.
Under tallene står kolonnenavnet (Name) og datatypen (dtype). En Series kan alt en kolonne i regnearket kan. Hele poenget er at du slipper løkker: regneoperasjoner virker på alle verdiene på én gang.
folk.sum() legger sammen alle verdiene, og max() og mean() gir den største verdien og gjennomsnittet. folk / 1000 deler hver verdi på \(1000\) og gir en ny Series. Du kan også regne med to kolonner, rad for rad. Vi regner ut hvor mange som bor per km², og legger resultatet inn som en ny kolonne:
Tabellen har fått en kolonne til. byer["tetthet"] = ... lager kolonnen, og er den der fra før, blir den overskrevet. round(0) runder alle tallene til hele tall, bare for visningen.
RegelRegne med kolonner
tabell["a"] # kolonnen a (Series)tabell["a"].sum() # summentabell["a"] /1000# hver verdi delt på 1000tabell["c"] = tabell["a"] / tabell["b"] # ny kolonne
Regneoperasjoner på en Series virker på alle verdiene på én gang, og to kolonner regnes sammen rad for rad. Statistikkmetodene sum(), mean(), min() og max() gir ett tall.
EksempelPoeng i prosent
Elevene i elever kunne ha \(60\) poeng til sammen. Lag kolonnen prosent og regn ut gjennomsnittet av den.
HintHint
elever["poeng"] / 60 * 100 gir prosenten for hver elev. Lagre den i en ny kolonne, og bruk mean() på den.
by                   Oslo
innbyggere         709000
areal                 454
tetthet       1561.674009
Name: 0, dtype: object
Bergen
Trondheim
iloc henter etter plass: byer.iloc[0] er første rad (som en Series, med kolonnene som indeks). loc henter etter navn: byer.loc[1, "by"] er raden med indeks \(1\) og kolonnen by, altså Bergen. Her er indeksen bare tallene \(0, 1, 2, \ldots\), så plass og navn blir det samme for radene. Det endrer seg når vi sorterer og filtrerer i 9.2.2.
RegelHente ut deler av en tabell
Kode
Gir
t["a"]
kolonnen a (Series)
t[["a", "b"]]
tabell med kolonnene a og b
t.iloc[2]
rad nummer 2 (teller fra 0)
t.loc[1, "a"]
verdien i rad med indeks 1, kolonne a
t.head(3)
de tre første radene
EksempelAreal for den tredje byen
Finn arealet til den tredje byen i byer, og skriv ut by og areal for alle byene.
HintHint
Den tredje raden har plass \(2\). Bruk loc eller iloc. Vil du ha to kolonner, gir du en liste med kolonnenavn.
LosningLøsning
print(byer.loc[2, "areal"])byer[["by", "areal"]]
342
by
areal
0
Oslo
454
1
Bergen
465
2
Trondheim
342
3
Stavanger
71
4
Tromsø
2521
Arealet til Trondheim er \(342\) km². Merk at telling fra \(0\) gjør at den tredje raden har nummer \(2\).
AdvarselVanlige feil
Kolonnenavnene er skrevet med små og store bokstaver akkurat som i tabellen: tabell["Areal"] gir KeyError hvis kolonnen heter areal.
tabell["a", "b"] virker ikke. Flere kolonner krever en liste: tabell[["a", "b"]].
tabell("a") med vanlige parenteser gir feil. En kolonne hentes med hakeparenteser.
Listene i ordboken må ha like mange elementer, ellers får du ValueError.
byer["tetthet"] = ... endrer selve tabellen. Det skjer bare når du lagrer i en kolonne, ikke når du bare regner (byer["areal"] / 2 endrer ingenting).
Teller rader fra \(0\): den første raden er iloc[0], ikke iloc[1].
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
I oppgavene under er byer tabellen fra teorien, uten kolonnen tetthet:
Tenk på hvor mange linjer du må skrive, og om du trenger en løkke.
AnswerFasit
Med en løkke eller en listeforståelse: sum(d["areal"] for d in liste).
Hvordan finner du den i tabell?
HintHint
Tenk på hvor mange linjer du må skrive, og om du trenger en løkke.
AnswerFasit
tabell["areal"].sum().
Hvorfor er det andre alternativet lettere når det er \(10\,000\) rader?
HintHint
Tenk på hvor mange linjer du må skrive, og om du trenger en løkke.
AnswerFasit
Med pandas skriver du like mye kode uansett hvor mange rader det er. Beregningen går i tillegg mye raskere, fordi pandas regner på hele kolonnen på én gang og ikke rad for rad i Python. Du får også statistikk, sortering og diagrammer med én linje.
Nivå 2
ExerciseFinn feilen: hente ut kolonner
Hver av linjene under gir en feilmelding. Forklar hva som er galt, og skriv linja riktig.
byer["Areal"]
HintHint
Les feilmeldingen. KeyError betyr at nøkkelen (kolonnenavnet) ikke finnes.
AnswerFasit
Kolonnen heter areal med liten bokstav. byer["areal"].
byer["by", "areal"]
HintHint
Les feilmeldingen. KeyError betyr at nøkkelen (kolonnenavnet) ikke finnes.
AnswerFasit
Flere kolonner må gis som en liste: byer[["by", "areal"]].
byer("areal")
HintHint
Les feilmeldingen. KeyError betyr at nøkkelen (kolonnenavnet) ikke finnes.
AnswerFasit
En kolonne hentes med hakeparenteser, ikke vanlige parenteser: byer["areal"].
pd.DataFrame({"a": [1, 2, 3], "b": [4, 5]})
HintHint
Les feilmeldingen. KeyError betyr at nøkkelen (kolonnenavnet) ikke finnes.
AnswerFasit
Listene har ulik lengde (\(3\) og \(2\)), og det gir ValueError. Begge kolonnene må ha like mange verdier, for eksempel "b": [4, 5, 6].
ExerciseTetthet
Lag kolonnen tetthet (innbyggere per km²) i byer, som i teorien. Avrund til hele tall.
z er \(1 \cdot 10 = 10\), \(2 \cdot 20 = 40\), \(3 \cdot 30 = 90\) og \(4 \cdot 40 = 160\), og summen er \(300\). Tabellen har fått en tredje kolonne, så formen er \((4, 3)\).
Kodeoppgaver
ExerciseLag en tabell
Skriv funksjonen lag_tabell(navn, poeng) som tar to lister og gir en DataFrame med kolonnene navn og poeng.
Lag en ordbok med nøklene "navn" og "poeng" og gi den til pd.DataFrame.
ExerciseTetthet for alle byene
Skriv funksjonen tetthet(tabell) som tar en DataFrame med kolonnene innbyggere og areal, og gir en Series med innbyggere per areal for hver rad.
Del kolonnen innbyggere på kolonnen areal. Du trenger ingen løkke.
ExerciseFra liste av ordbøker til tabell
Skriv funksjonen til_tabell(rader) som tar en liste av ordbøker med samme nøkler og gir en DataFrame. Hver ordbok skal bli en rad.
pd.DataFrame kan ta en liste av ordbøker direkte.
ExerciseFinn feilen: summen av en kolonne
Funksjonen skal gi summen av en kolonne, men gir feil. Finn og rett feilen.
Hva er forskjellen på "kolonne" med anførselstegn og kolonne uten?
Utfordringer
ExerciseTilbake til ordbøker
Skriv funksjonen til_rader(tabell) som gjør en DataFrame om til en liste av ordbøker, én per rad (det motsatte av til_tabell). Bruk tabell.to_dict("records"), eller lag lista selv med en løkke over radene.
to_dict tar en parameter som bestemmer formen på resultatet. Prøv "records" på en liten tabell og se på resultatet.
ExerciseNår er pandas verdt det?
Du har en CSV-fil med navn og poeng for \(30\) elever og vil bare finne ut hvem som har flest poeng. Hvilken løsning velger du: løkke over csv.DictReader eller pandas? Hva hvis filen har \(50\) kolonner og \(200\,000\) rader, og du skal regne gjennomsnitt per kolonne? Begrunn.
AnswerFasit
For \(30\) elever og ett spørsmål er en løkke helt fint, og du slipper å laste inn et stort bibliotek. Med \(50\) kolonner og \(200\,000\) rader vinner pandas klart: du regner snittet av alle kolonnene med én linje (tabell.mean()), og det går raskt. Du får også overblikk (info(), describe()), sortering, gruppering og diagrammer uten å skrive det selv. Tommelfingerregel: pandas lønner seg når datasettet er stort, har mange kolonner, eller du skal stille mange ulike spørsmål til det.
Oppsummering
Lage en tabell
import pandas as pdt = pd.DataFrame({"a": [1, 2],"b": [3, 4],})
t["a"] # Seriest[["a", "b"]] # tabellt.iloc[0] # første radt.loc[1, "a"] # verdi
Regne på kolonner
t["a"].sum()t["a"].mean()t["c"] = t["a"] / t["b"]
Kolonnenavn skrives nøyaktig som i tabellen, og flere kolonner gis som en liste (doble klammer).
Du slipper løkker: regning på en kolonne virker på alle verdiene på én gang.
9.1.2 Lese CSV og JSON
I kapittel 8 leste du CSV og JSON med csv og json, og laget lister og ordbøker selv. Datasett fra virkeligheten er sjelden pene. En fil fra SSB har semikolon mellom kolonnene, komma som desimaltegn og to punktum der tallet mangler. Les du den uten å tenke på det, får du én lang kolonne med tekst i stedet for en tabell.
pandas leser en hel fil inn som en DataFrame med én linje, og har parametere for alle de vanlige uvanene. Det viktigste er å se på rådataene først og fortelle pandas hvordan de er bygd opp.
Læringsmål
Etter dette delkapittelet skal du kunne
lese en CSV-fil inn i en DataFrame med pd.read_csv,
bruke sep, decimal, na_values, encoding, skiprows og index_col for å lese filer med norsk format,
lese JSON med pd.read_json og pd.json_normalize, også når dataene er nøstet,
sjekke at innlesingen ble riktig, og lagre en tabell med to_csv.
Lese en CSV-fil
Vi trenger en CSV-fil å lese. I boka legger vi innholdet i en tekststreng og bruker io.StringIO, som lar pandas lese teksten som om den var en fil. Med en ekte fil gir du filnavnet i stedet: pd.read_csv("temperatur.csv").
import ioimport pandas as pdtekst ="""måned,temp,nedbørjanuar,-4.3,49februar,-3.8,36mars,0.9,47april,5.2,41"""t = pd.read_csv(io.StringIO(tekst))t
måned
temp
nedbør
0
januar
-4.3
49
1
februar
-3.8
36
2
mars
0.9
47
3
april
5.2
41
Første linje ble kolonnenavn, og pandas gjetter selv typene: temp ble desimaltall og nedbør heltall. Sjekk alltid at det ble riktig:
Lest fra en ekte fil har read_csv samme parametere. Skal du bruke relativ filsti, må filen ligge i mappa programmet kjøres fra. Får du FileNotFoundError, sjekk filnavnet og mappa, for eksempel med Path.cwd() og Path("data").exists() fra kapittel 8.
Leser en CSV-fil (eller tekst) inn som en DataFrame. Første linje blir kolonnenavn, og pandas gjetter datatypene.
EksempelLes inn og sjekk
Les teksten under inn med pandas. Hvor mange rader og kolonner er det, og hva er gjennomsnittet av poeng?
navn,poeng
Kari,45
Ola,38
Mia,51
HintHint
Legg teksten i en variabel, og bruk io.StringIO med pd.read_csv. shape gir størrelsen, og mean() gir snittet.
LosningLøsning
tekst ="navn,poeng\nKari,45\nOla,38\nMia,51\n"elever = pd.read_csv(io.StringIO(tekst))print(elever.shape)print(elever["poeng"].mean())
(3, 2)
44.666666666666664
Tabellen har \(3\) rader og \(2\) kolonner, og snittet er \(44{,}67\). Første linje ble brukt som kolonnenavn, så den teller ikke som en rad.
Norske filer: skilletegn, desimaler og manglende tall
Norske programmer lagrer ofte CSV annerledes. Siden komma er desimaltegn, brukes semikolon mellom kolonnene. Og når et tall mangler, står det ofte to punktum (..) eller en tom plass. Her er samme slags data på norsk format:
norsk ="""måned;temp;nedbørjanuar;-4,3;49februar;-3,8;36mars;0,9;..april;5,2;41"""feil = pd.read_csv(io.StringIO(norsk))print(feil.shape)print(list(feil.columns))
(4, 1)
['måned;temp;nedbør']
Uten hjelp finner ikke pandas skilletegnet, og hele linja blir én kolonne. Vi sier fra med tre parametere:
     måned  temp  nedbør
0   januar  -4.3    49.0
1  februar  -3.8    36.0
2     mars   0.9     NaN
3    april   5.2    41.0
måned         str
temp      float64
nedbør    float64
dtype: object
sep=";" er skilletegnet, decimal="," forteller at komma er desimaltegn, og na_values=".." sier at .. betyr «mangler». Manglende verdier vises som NaN (not a number), og kolonnen nedbør ble desimaltall, siden NaN ikke kan være et heltall. Hvordan du håndterer manglende verdier, er temaet i 9.2.1. Uten decimal og na_values ville temp og nedbør blitt tekst, og du kunne ikke regnet med dem.
Flere parametere du kommer til å trenge:
Parameter
Hva den gjør
sep=";"
skilletegn mellom kolonnene
decimal=","
komma som desimaltegn
na_values=".."
tekst som betyr «mangler»
encoding="utf-8"
tegnkoding (se 8.1.2). Eldre filer fra Excel bruker ofte "latin-1".
skiprows=2
hopp over de to første linjene (f.eks. en tittel)
header=None
filen har ingen overskriftsrad
index_col="måned"
bruk en kolonne som indeks
usecols=["a", "b"]
les bare disse kolonnene
RegelÅpne en ukjent fil
Se på de første linjene i en teksteditor (eller print(tekst[:300])). Hva skiller kolonnene? Hvilket tegn er desimaltegn? Hva står der når noe mangler? Er det tittellinjer før overskriftene?
Les inn med de parameterne du fant.
Sjekk shape, head() og dtypes. Er tall blitt tall? Er det riktig antall kolonner?
NoteRart i tegnene?
Står det Ã¥ i stedet for å, eller �, er koden feil. Les filen på nytt med encoding="utf-8", eller "latin-1" hvis den kommer fra et eldre program. Se 8.1.2.
EksempelLes en fil fra SSB
Filen under har en tittellinje, semikolon, desimalkomma og .. for manglende verdi. Les den riktig inn, og finn det høyeste innbyggertallet.
Hopp over den første linja, og gi sep, decimal og na_values til read_csv. max() hopper over NaN.
LosningLøsning
tekst ="""Tabell: Folkemengdekommune;innbyggere;vekstAlfa;12000;1,2Beta;..;0,4Gamma;8500;-0,3"""t = pd.read_csv( io.StringIO(tekst), skiprows=1, sep=";", decimal=",", na_values="..",)print(t)print(t["innbyggere"].max())
  kommune  innbyggere  vekst
0    Alfa     12000.0    1.2
1    Beta         NaN    0.4
2   Gamma      8500.0   -0.3
12000.0
skiprows=1 hopper over tittellinja, så kommune blir overskrift. .. ble til NaN, og max() ser bort fra den. Svaret er \(12000\).
Lese JSON
JSON, som du kjenner fra kapittel 8, er vanlig når data kommer fra et API. Er JSON-en en liste av objekter med de samme nøklene, er den allerede en tabell, og pd.read_json leser den direkte:
tekst ='[{"by": "Oslo", "temp": 5.2}, {"by": "Bergen", "temp": 7.1}]'pd.read_json(io.StringIO(tekst))
by
temp
0
Oslo
5.2
1
Bergen
7.1
(Med en fil bruker du filnavnet: pd.read_json("data.json").) Er dataene nøstet, med objekter inni objekter, gjør du dem først om til Python-data med json.loads, og så flater du dem ut med pd.json_normalize:
Hver nøkkel inni data ble en egen kolonne, og navnet er satt sammen av nøklene med punktum: data.temp og data.nedbor. Vil du ha kortere navn, bruker du rename (se 9.2.2) eller setter df.columns selv.
RegelLese JSON
pd.read_json("fil.json") # liste av like objekterpd.json_normalize(json.loads(tekst)) # nøstede objekter
Er svaret fra API-et pakket inn i et ekstra objekt ({"resultat": [...]}), henter du lista først: json.loads(tekst)["resultat"].
Lagre en tabell og sjekke innlesingen
Vil du lagre en rensket tabell, bruker du to_csv. Uten index=False får filen en ekstra kolonne med radnumrene:
Gir du et filnavn (t.to_csv("rensket.csv", index=False)), skrives det til en fil, og to_csv(..., sep=";", decimal=",") lager norsk format. Gjør det til en vane å lese inn og se på tabellen med en gang: se på head(), shape og dtypes, før du regner på dataene.
EksempelNøstede data fra et API
Et API ga denne JSON-teksten. Lag en tabell med én rad per elev, og finn snittet av poeng.prove1.
Tabellen har kolonnene navn, poeng.prove1 og poeng.prove2. Snittet av poeng.prove1 er \((45 + 30) / 2 = 37{,}5\).
AdvarselVanlige feil
Du leser en norsk CSV uten sep=";". Resultatet er én kolonne med lange navn og shape med bare én kolonne.
Du glemmer decimal=",". Tallene blir tekst, og mean() feiler eller gir tull.
Du glemmer na_values, så .. blir stående som tekst, og hele kolonnen blir tekst.
Du leser pd.read_json(tekst) med en vanlig tekst. Nyere pandas krever io.StringIO(tekst) eller et filnavn.
Du bruker read_json på nøstet JSON og får en kolonne med ordbøker i hver celle. Bruk json_normalize.
Du lagrer med to_csv uten index=False, og får en overflødig kolonne ved neste innlesing.
Filen ligger ikke i mappa programmet kjører fra, og du får FileNotFoundError.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHvilken parameter?
Hva må du gi til pd.read_csv for å lese hver av filene riktig?
Denne teksten leses med pd.read_csv(io.StringIO(tekst)), uten andre parametere:
by,areal
Oslo,454
Bergen,465
Trondheim,342
Hvor mange rader er det i tabellen?
Hvor mange kolonner?
Hva blir summen av areal?
ExerciseHva går galt?
Filen varer.csv ser slik ut:
vare;pris
Brød;32,5
Melk;19,9
Du leser den med pd.read_csv("varer.csv"). Beskriv hva som skjer, og hvordan du fikser det.
HintHint
Hva skiller kolonnene i filen, og hva er desimaltegnet?
AnswerFasit
Uten sep leter pandas etter komma. Det finnes ingen, så hele linja blir én kolonne med navnet vare;pris, og tabellen har bare én kolonne. Fiks: pd.read_csv("varer.csv", sep=";", decimal=","). decimal="," gjør at 32,5 leses som tallet \(32{,}5\) og ikke som tekst.
Nivå 2
ExerciseFinn feilen: innlesingen
Programmet skal lese filen og skrive ut gjennomsnittsprisen, men feiler. Hva er galt?
import ioimport pandas as pdtekst ="vare;pris\nBrød;32,5\nMelk;19,9\nSmør;..\n"t = pd.read_csv(io.StringIO(tekst), sep=";")print(t["pris"].mean())
HintHint
Hva slags datatype har pris når pandas ikke vet om desimalkomma og ..?
AnswerFasit
Uten decimal="," og na_values=".." blir hele kolonnen pris tekst, og mean() gir en feilmelding (TypeError). Rett:
t = pd.read_csv(io.StringIO(tekst), sep=";", decimal=",", na_values="..")print(t["pris"].mean()) # 26.2
mean() hopper over den manglende verdien, så snittet er \((32{,}5 + 19{,}9) / 2 = 26{,}2\).
Hva heter kolonnene i pd.json_normalize(json.loads(tekst))?
HintHint
json_normalize setter sammen nøklene med punktum.
AnswerFasit
by, vaer.temp og vaer.vind.
Hvordan henter du ut vindstyrkene?
HintHint
json_normalize setter sammen nøklene med punktum.
AnswerFasit
tabell["vaer.vind"], som gir \(3\) og \(6\).
Hvorfor virker ikke pd.read_json(io.StringIO(tekst)) like bra her?
HintHint
json_normalize setter sammen nøklene med punktum.
AnswerFasit
read_json lager bare kolonnene by og vaer, og hver celle i vaer blir en hel ordbok. Du kan ikke regne på temp og vind uten å først hente dem ut. json_normalize flater ut ordbøkene til egne kolonner.
ExerciseLese, rense og lagre
Du leser en tabell, og vil lagre den som norsk CSV til en annen. Skriv kode som
leser norsk (se teorien) riktig,
regner ut kolonnen temp_f (temperatur i grader Fahrenheit: \(F = C \cdot 1{,}8 + 32\)),
skriver tabellen som norsk CSV-tekst uten indeks.
HintHint
to_csv tar parameterne index, sep og decimal. Uten filnavn gir den teksten tilbake.
Utskriften starter med måned;temp;nedbør;temp_f, og januar blir januar;-4,3;49,0;24,26, siden \(-4{,}3 \cdot 1{,}8 + 32 = 24{,}26\). Uten round(2) får du mange desimaler (24,259999999999998), fordi desimaltall ikke lagres helt nøyaktig. Manglende verdier blir tomme felt.
Kodeoppgaver
ExerciseLes en CSV-tekst
Skriv funksjonen les_csv(tekst) som leser en CSV-tekst med komma som skilletegn og gir en DataFrame.
Bruk io.StringIO(tekst) rundt teksten, og gi den til pd.read_csv.
ExerciseLes norsk CSV
Skriv funksjonen les_norsk(tekst) som leser CSV i norsk format: semikolon som skilletegn, komma som desimaltegn og .. for manglende verdi.
Du trenger tre parametere: sep, decimal og na_values.
ExerciseLes nøstet JSON
Skriv funksjonen les_json(tekst) som tar en JSON-tekst med en liste av objekter. Hvert objekt har nøkkelen by og et objekt maling med temp og regn. Funksjonen skal gi en DataFrame med kolonnene by, temp og regn (uten maling. foran).
pd.json_normalize gir kolonnene by, maling.temp og maling.regn. Gi nytt navn til kolonnene med rename(columns=...), eller sett t.columns = [...].
ExerciseFinn feilen: norsk innlesing
Funksjonen skal gi gjennomsnittsprisen fra en norsk CSV, men gir feil. Rett den.
Uten hjelp leses 32,5 og .. som tekst. Hvilke to parametere mangler?
Utfordringer
ExerciseGjett skilletegnet
Skriv funksjonen les_ukjent(tekst) som leser en CSV-tekst med enten komma eller semikolon som skilletegn, og gir en DataFrame. Funksjonen skal se på første linje: har den flest semikolon, brukes ;, ellers ,. Er skilletegnet ;, skal komma være desimaltegn.
Ta første linje med tekst.split("\n")[0], og tell med count(";") og count(","). Velg sep og decimal ut fra svaret.
ExerciseFra CSV til JSON
Du har en CSV-tekst med kolonnene navn og poeng, og vil gi dem som JSON til en annen tjeneste. Hvordan gjør du det med pandas? Skriv koden, og forklar hvorfor orient="records" passer her.
AnswerFasit
t = pd.read_csv(io.StringIO(tekst))print(t.to_json(orient="records", force_ascii=False))
For navn,poeng med Kari (\(45\)) og Ola (\(38\)) gir det [{"navn":"Kari","poeng":45},{"navn":"Ola","poeng":38}]. orient="records" lager en liste med ett objekt per rad, med kolonnenavnene som nøkler. Det er formen de fleste API-er forventer, og den samme som read_json leser tilbake. force_ascii=False gjør at æ, ø og å blir stående som de er.
Se på rådataene først: skilletegn, desimaltegn, hva som står når noe mangler.
Sjekk alltid shape, head() og dtypes etter innlesing.
9.2 Vasking og transformasjon
Ekte data har hull, skrivefeil og rader som er registrert to ganger. Før du kan stole på et gjennomsnitt, må du rydde. Denne seksjonen handler om å finne og rette feil i dataene, og om å plukke ut, sortere og regne om det du trenger.
9.2.1 Manglende og feil data
Elevene i en klasse har satt opp en værstasjon og logger temperatur og nedbør hver dag. Når de regner ut gjennomsnittstemperaturen for den første uka i mars, får de \(-331{,}7\) grader. Noe er galt. Ser de på dataene, finner de at sensoren skriver \(-999\) når den ikke får målt, at noen målinger mangler, at én dag er registrert to ganger, og at stedet er skrevet både som «Skolen» og «skolen ».
Slik ser nesten alle ekte datasett ut. Å vaske data betyr å finne og rette slike feil før du regner. Det er ofte den største delen av jobben, og det er her du avgjør om svaret blir til å stole på.
Læringsmål
Etter dette delkapittelet skal du kunne
finne manglende verdier med isna() og info(),
fjerne eller fylle inn manglende verdier med dropna() og fillna(), og begrunne valget,
rette feil verdier og feil typer med replace(), pd.to_numeric() og tekstmetodene i str,
Tomme felt blir NaN, som du så i 9.1.2. Er tabellen stor, ser du ikke hullene ved å se på den. Da spør du pandas. isna() gir True der en verdi mangler, og sum() teller dem, siden True regnes som \(1\):
print(logg.isna().sum())
dato      0
sted      0
temp      1
nedbor    2
dtype: int64
To nedbørsmålinger og én temperatur mangler. logg.info() gir det samme overblikket, med antall verdier som ikke mangler (Non-Null Count) i hver kolonne.
Statistikkmetodene hopper over NaN. count() teller verdiene som finnes, og mean() deler på det antallet:
Det er derfor snittet ble \(-331{,}7\) og ikke en feilmelding. Hullene gjør ikke at regningen stopper, men de to målingene på \(-999\) drar snittet helt ned. Dem skal vi rette etterpå.
DefinisjonManglende verdi
En manglende verdi vises som NaN (not a number) i pandas. t.isna() gir True der en verdi mangler, og t.isna().sum() teller dem per kolonne. sum(), mean(), count(), min() og max() hopper over NaN.
EksempelTell hullene
I tabellen under mangler noen poeng. Hvor mange mangler, og hva er snittet av poengene som finnes?
Uten subset mister vi tre av sju rader, også de to dagene der temperaturen finnes og det bare er nedbøren som mangler. Skal vi regne på temperaturen, er det bare hull i temp som er et problem.
fillna() setter inn en verdi der det mangler. Hvilken verdi som er riktig, avhenger av hva dataene betyr:
Er det riktig at det ikke regnet de to dagene? Det vet vi ikke. Kanskje var regnmåleren tett. Fyller du inn \(0\), sier du at det var tørt, og summen av nedbør blir for lav. Fyller du inn snittet (fillna(logg["nedbor"].mean())), blir summen mer realistisk, men dagene ser like ut selv om de ikke var det. Ofte er det ærligste å la hullene stå og si hvor mange det var.
RegelFjerne eller fylle inn
t = t.dropna() # fjern rader med hullt = t.dropna(subset=["a"]) # bare hull i a tellert["a"] = t["a"].fillna(0) # fyll inn 0t["a"] = t["a"].fillna(t["a"].mean())
dropna() og fillna() gir en ny tabell eller kolonne, så du må lagre resultatet. Velg ut fra hva hullene betyr, og skriv ned hva du gjorde. Fyller du inn verdier, endrer du dataene.
EksempelHvilket valg?
En tabell har kolonnene navn, klasse og fravaer (antall dager). Hos tre elever står fravaer tomt, fordi de begynte på skolen i går. Hva gjør du hvis du skal finne snittfraværet?
HintHint
Hva betyr et tomt felt her? Har de null fravær, eller vet vi ikke?
LosningLøsning
Elevene har ikke vært på skolen lenge nok til at fraværet sier noe. Fyller du inn \(0\), trekker du snittet ned. Snittet av de andre er det riktige, og det får du med t["fravaer"].mean(), som hopper over hullene. Vil du ha en tabell uten dem, bruker du t.dropna(subset=["fravaer"]). Skriv i rapporten at tre elever er holdt utenfor og hvorfor.
Feil verdier og feil typer
Mange datasett bruker et eget tall for «mangler», som \(-999\) eller \(9999\). For pandas er det et vanlig tall, og det må gjøres om til NaN. Det kan du gjøre ved innlesing (na_values=[-999]), eller etterpå med replace:
Nå er snittet \(1{,}95\) grader, som er rimelig for mars. float("nan") er NaN laget med vanlig Python.
Tekst har sine egne feil: mellomrom på slutten, store og små bokstaver og ulike skrivemåter. value_counts() viser hvilke verdier som finnes og hvor mange det er av hver, og da ser du variantene:
str.strip() fjerner mellomrom i begge ender, og str.capitalize() gir stor forbokstav og små bokstaver ellers. str.lower(), str.upper() og str.replace("a", "b") virker på samme måte.
Har noen skrevet tekst i en tallkolonne, blir hele kolonnen tekst. pd.to_numeric gjør kolonnen om til tall, og med errors="coerce" blir det som ikke er et tall, til NaN i stedet for en feilmelding:
Det blir to klasser: 2IT (tre elever) og 3IT (én).
Duplikater
Den 3. mars er registrert to ganger. Slike duplikater oppstår når data slås sammen fra flere filer, eller når et program lagrer det samme to ganger. De gjør at noen målinger teller dobbelt. duplicated() gir True for rader som er like en rad lenger opp, og drop_duplicates() fjerner dem:
Bare helt like rader regnes som duplikater. Vil du si at to rader med samme dato er en dobbeltregistrering, selv om tallene er litt ulike, bruker du drop_duplicates(subset=["dato"]). Da beholdes den første.
Nå er loggen vasket: \(-999\) er NaN, stedene er skrevet likt, og 3. mars står én gang. Merk at indeksen hopper over \(3\), siden den raden er fjernet:
logg
dato
sted
temp
nedbor
0
2026-03-01
Skolen
2.5
4.1
1
2026-03-02
Skolen
3.1
NaN
2
2026-03-03
Skolen
NaN
0.0
4
2026-03-04
Hytta
1.8
2.2
5
2026-03-05
Hytta
NaN
1.0
6
2026-03-06
Hytta
0.4
NaN
RegelDuplikater
t.duplicated().sum() # antall duplikatert = t.drop_duplicates()t = t.drop_duplicates(subset=["dato"])
AdvarselVanlige feil
Du skriver t.dropna() eller t["a"].fillna(0) uten å lagre resultatet. Tabellen er uendret. Skriv t = t.dropna() eller t["a"] = t["a"].fillna(0).
Du fyller inn \(0\) der en verdi mangler, uten å tenke over hva det betyr. Det endrer summer og snitt.
Du bruker dropna() uten subset og mister rader du trengte.
Du ser ikke etter koder som \(-999\). De er vanlige tall for pandas og ødelegger snittet uten feilmelding.
Du retter tekst før du har sett på value_counts(), og overser varianter.
Du fjerner duplikater før du har vasket teksten. «Skolen» og «skolen » er ikke like før du har brukt strip().
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
I flere av oppgavene under er salg denne tabellen fra en kiosk:
Hva ville du gjort med de manglende verdiene i hvert tilfelle? Begrunn.
Et spørreskjema der noen ikke har svart på hvor gamle de er.
AnswerFasit
La hullene stå, eller fjern radene når du regner på alder (dropna(subset=["alder"])). Å fylle inn snittalderen ville gitt et falskt inntrykk av at alle har svart, og snittet ville sett sikrere ut enn det er.
En logg over antall besøkende i en butikk, der telleren var av én dag.
AnswerFasit
Ikke fyll inn \(0\), for butikken var åpen. Du kan la dagen stå tom og si at den mangler, eller fylle inn et anslag (f.eks. snittet for samme ukedag) hvis du forklarer det.
En liste over bøker der noen mangler sideantall, og du skal finne den lengste boka.
AnswerFasit
La hullene stå. max() hopper over NaN, og bøkene uten sideantall kan uansett ikke vinne. Si gjerne at noen bøker manglet tall, siden en av dem kan være den lengste.
Nivå 2
ExerciseFinn feilen: tabellen blir ikke vasket
Programmet skal fjerne radene uten temperatur og fylle inn \(0\) for manglende nedbør, men tabellen er uendret etterpå. Hva er galt?
Etter strip() og lower() er verdiene ja, ja, nei, ja og nei. Det er tre ja og to ulike verdier.
ExerciseTall som tekst
Kolonnen pris ble lest inn som tekst, med verdiene "32,50", "19.90", "gratis" og "45".
Hva blir pd.to_numeric(pris, errors="coerce").tolist()?
HintHint
errors="coerce" gir NaN for alt som ikke kan leses som et tall. Komma er ikke desimaltegn i Python.
AnswerFasit
[nan, 19.9, nan, 45.0]
Hvordan får du med 32,50?
HintHint
errors="coerce" gir NaN for alt som ikke kan leses som et tall. Komma er ikke desimaltegn i Python.
AnswerFasit
Bytt komma med punktum først: pd.to_numeric(pris.str.replace(",", "."), errors="coerce") gir [32.5, 19.9, nan, 45.0].
Hva bør du gjøre med "gratis"?
HintHint
errors="coerce" gir NaN for alt som ikke kan leses som et tall. Komma er ikke desimaltegn i Python.
AnswerFasit
«gratis» betyr pris \(0\), så her er det riktig å bytte det ut: pris.replace("gratis", "0") før to_numeric. Det er et eksempel på at du må vite hva dataene betyr før du vasker dem.
ExerciseHvor mye snittet endrer seg
Temperaturene i en uke er \(4\), \(6\), NaN, \(5\), \(-999\), \(7\) og NaN.
Hva gir mean() før vasking?
Hva gir mean() når \(-999\) er byttet med NaN?
Hva gir mean() hvis du i tillegg fyller alle hull med \(0\)?
Kodeoppgaver
ExerciseAntall hull
Skriv funksjonen antall_hull(tabell) som gir antall manglende verdier i hele tabellen, som et heltall.
tabell.isna().sum() gir antallet per kolonne. Legg sammen én gang til.
ExerciseFjern sensorfeil
Sensoren skriver \(-999\) når den ikke får målt. Skriv funksjonen fjern_feil(tabell) som gir en ny tabell der \(-999\) i kolonnen temp er byttet med NaN, og der radene uten temperatur er fjernet.
Lag en kopi (ny = tabell.copy()), bruk replace på kolonnen, og så dropna(subset=["temp"]).
ExerciseRydd i navnene
Skriv funksjonen rydd_navn(navn) som tar en Series med navn og gir en ny Series der mellomrom i endene er fjernet og navnene har stor forbokstav.
Bruk str.strip() og så str.capitalize().
ExerciseFinn feilen: tall med komma
Funksjonen skal gjøre en kolonne med tekst om til tall. Komma er desimaltegn, og det som ikke er tall, skal bli NaN. Den gir feil. Rett den.
to_numeric kjenner ikke komma som desimaltegn. Bytt det ut med str.replace først.
Utfordringer
ExerciseVask hele loggen
Skriv funksjonen vask(tabell) som tar en logg med kolonnene dato, sted og temp og gir en vasket kopi der
stedene har stor forbokstav og ingen mellomrom i endene,
\(-999\) i temp er byttet med NaN,
duplikater er fjernet,
indeksen går fra \(0\) igjen (reset_index(drop=True)).
Rekkefølgen er viktig. Tenk gjennom hvorfor.
Rydd teksten før du fjerner duplikater. Ellers er «Skolen» og «skolen » ulike, og duplikatet blir stående.
ExerciseNår hullene ikke er tilfeldige
En skole lager en spørreundersøkelse om trivsel. \(30\) % av elevene svarer ikke. De som svarer, gir et snitt på \(4{,}5\) av \(5\). Rektor sier at elevene trives svært godt. Hva er problemet? Ville det hjulpet å fylle inn snittet for dem som ikke svarte?
AnswerFasit
Problemet er at de som ikke svarer, kan være annerledes enn de som svarer. Elever som trives dårlig, er kanskje mindre motivert til å svare, eller er borte fra skolen. Da er snittet for de som svarte, for høyt, og vi vet ikke hvor mye. Å fylle inn \(4{,}5\) for dem som ikke svarte, hjelper ikke. Det skjuler bare problemet, fordi det ser ut som alle har svart det samme. Det ærlige er å si at \(30\) % ikke svarte, og at snittet bare gjelder dem som svarte. Manglende data er et problem når hvem som mangler, henger sammen med det du måler.
Oppsummering
Finne hull
t.isna().sum()t.info()t["a"].count()
Fjerne og fylle inn
t = t.dropna()t = t.dropna(subset=["a"])t["a"] = t["a"].fillna(0)
dropna(), fillna() og drop_duplicates() gir en ny tabell. Lagre resultatet.
Å fylle inn verdier endrer dataene. Tenk over hva hullene betyr, og skriv ned hva du gjorde.
9.2.2 Filtrere, sortere og lage nye kolonner
En treningsapp lagrer hver tur du tar: dato, aktivitet, antall kilometer og hvor lang tid det tok. Appen kan svare på spørsmål som «Hvilke løpeturer var lengre enn fem kilometer?» og «Hva var den raskeste turen?». Bak slike svar ligger tre enkle operasjoner: plukke ut radene som passer, sortere dem og regne ut nye tall av de gamle.
I regnearket gjør du det med filter, sortering og en formel i en ny kolonne. Med pandas skriver du det som én linje kode hver, og du kan kjøre den samme analysen på nytt når det kommer nye turer.
Læringsmål
Etter dette delkapittelet skal du kunne
filtrere rader med en betingelse, og kombinere betingelser med &, | og ~,
sortere en tabell på én eller flere kolonner,
lage nye kolonner med regning, med map og med apply,
Setter du den inne i hakeparentesene, får du bare radene der det står True. Det kalles å filtrere:
turer[turer["km"] >5]
dato
aktivitet
km
minutter
1
04.09
Sykkel
22.5
61
3
07.09
Løp
8.1
47
4
09.09
Sykkel
15.0
45
6
12.09
Gå
6.5
80
Les det som «turer der km er større enn 5». Legg merke til indeksen: radene beholder nummeret de hadde. Det er derfor loc og iloc kan gi ulike svar etter filtrering. iloc[0] er den første raden nå (indeks \(1\)), mens loc[0] leter etter indeks \(0\), som er filtrert bort.
Vil du kombinere betingelser, bruker du & for «og», | for «eller» og ~ for «ikke». Hver betingelse må stå i parentes:
Å lagre betingelsene i variabler gjør koden lettere å lese. Skal en kolonne være én av flere verdier, er isin kortere enn mange |:
turer[turer["aktivitet"].isin(["Løp", "Gå"])]
dato
aktivitet
km
minutter
0
03.09
Løp
5.0
28
2
06.09
Gå
4.2
50
3
07.09
Løp
8.1
47
5
10.09
Løp
3.0
15
6
12.09
Gå
6.5
80
RegelFiltrere
t[t["a"] >5] # a større enn 5t[(t["a"] >5) & (t["b"] =="x")] # ogt[(t["a"] >5) | (t["a"] <0)] # ellert[~(t["b"] =="x")] # ikket[t["b"].isin(["x", "y"])] # én av flere
Inne i hakeparentesene står en Series med True og False, og du får radene der det står True. Bruk &, | og ~, ikke and, or og not, og sett parentes rundt hver betingelse.
EksempelKorte sykkelturer
Hvilke sykkelturer tok under en time? Hvor mange kilometer syklet du på dem til sammen?
HintHint
Lag to betingelser, én for aktiviteten og én for minuttene, og kombiner dem med &. Bruk sum() på kolonnen km i resultatet.
    dato aktivitet    km  minutter
4  09.09    Sykkel  15.0        45
15.0
Bare turen 9.09 passer, med \(15\) km. Turen 4.09 var en sykkeltur, men tok \(61\) minutter.
Sortere
sort_values sorterer tabellen etter en kolonne. Uten mer blir det stigende, og med ascending=False synkende:
turer.sort_values("km", ascending=False)
dato
aktivitet
km
minutter
1
04.09
Sykkel
22.5
61
4
09.09
Sykkel
15.0
45
3
07.09
Løp
8.1
47
6
12.09
Gå
6.5
80
0
03.09
Løp
5.0
28
2
06.09
Gå
4.2
50
5
10.09
Løp
3.0
15
Igjen følger indeksen med radene. Vil du ha de tre lengste turene, sorterer du og tar head(3). Vil du at indeksen skal gå fra \(0\) igjen, legger du til reset_index(drop=True). Du kan også sortere på flere kolonner, for eksempel først aktivitet og så kilometer innenfor hver aktivitet:
turer.sort_values(["aktivitet", "km"])
dato
aktivitet
km
minutter
2
06.09
Gå
4.2
50
6
12.09
Gå
6.5
80
5
10.09
Løp
3.0
15
0
03.09
Løp
5.0
28
3
07.09
Løp
8.1
47
4
09.09
Sykkel
15.0
45
1
04.09
Sykkel
22.5
61
Tekst sorteres alfabetisk, men bokstavene æ, ø og å kommer etter z, fordi Python sammenligner tegnkodene (se 8.1.2). Store bokstaver kommer før små.
RegelSortere
t.sort_values("a") # stigendet.sort_values("a", ascending=False) # synkendet.sort_values(["a", "b"]) # først a, så bt.sort_values("a").head(3) # de tre minstet.reset_index(drop=True) # ny indeks 0, 1, 2 ...
EksempelDen lengste løpeturen
Hvilken dato var den lengste løpeturen?
HintHint
Filtrer først på løping, sorter synkende på km, og ta den første raden med iloc[0].
Den lengste løpeturen var 7.09, med \(8{,}1\) km. Her må vi bruke iloc[0] og ikke loc[0], siden raden med indeks \(0\) ikke står først etter sorteringen.
Nye kolonner
I 9.1.1 laget du nye kolonner ved å regne med andre kolonner. Den gjennomsnittlige farten i km/t er kilometer delt på timer:
apply kaller niva én gang for hver rad. Det er tregere enn å regne på hele kolonnen på én gang, så bruk vanlig regning når du kan, og apply når du trenger en regel.
Til slutt kan du gi kolonner nytt navn med rename og fjerne dem med drop:
kort = turer.rename(columns={"minutter": "min"})kort = kort.drop(columns=["niva"])print(list(kort.columns))
Turen 10.09 var raskest, med \(5{,}0\) minutter per kilometer. Den var også den korteste, så det er ikke rart.
AdvarselVanlige feil
Du skriver and eller or mellom to betingelser. Det gir ValueError: The truth value of a Series is ambiguous. Bruk & og |.
Du glemmer parentesene: t["a"] > 5 & t["b"] < 3 blir regnet ut i feil rekkefølge, siden & regnes før >. Skriv (t["a"] > 5) & (t["b"] < 3).
Du skriver = i stedet for == i en betingelse.
Du bruker loc[0] etter filtrering eller sortering og venter å få den første raden. Bruk iloc[0].
Du sorterer eller fjerner kolonner uten å lagre resultatet: t.sort_values("a") endrer ikke t.
Du filtrerer og endrer så en kolonne i resultatet. Lag en kopi med .copy() hvis du vil endre et utvalg uten at pandas advarer.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
I oppgavene under er turer tabellen fra starten av teorien, med kolonnene dato, aktivitet, km og minutter.
Hver linje gir en feil eller et feil svar. Forklar hvorfor, og rett den.
turer[turer["km"] > 5 and turer["minutter"] < 60]
HintHint
Tenk på and mot &, hva som regnes ut først, og hva loc leter etter.
AnswerFasit
and virker ikke på en hel Series og gir ValueError. Bruk & og parenteser: turer[(turer["km"] > 5) & (turer["minutter"] < 60)].
turer[turer["km"] > 5 & turer["minutter"] < 60]
HintHint
Tenk på and mot &, hva som regnes ut først, og hva loc leter etter.
AnswerFasit
& regnes ut før > og <, så Python prøver å regne 5 & turer["minutter"]. Sett parentes rundt hver betingelse, som i a).
turer[turer["aktivitet"] = "Løp"]
HintHint
Tenk på and mot &, hva som regnes ut først, og hva loc leter etter.
AnswerFasit
= er tilordning. Sammenligning er ==: turer[turer["aktivitet"] == "Løp"].
turer.sort_values("km") etterfulgt av print(turer.loc[0]), for å få den korteste turen
HintHint
Tenk på and mot &, hva som regnes ut først, og hva loc leter etter.
AnswerFasit
sort_values endrer ikke turer, og loc[0] gir raden med indeks \(0\), ikke den første raden. Skriv sortert = turer.sort_values("km") og print(sortert.iloc[0]).
bestatt er True for Ada (\(12\)) og Cy (\(15\)). En kolonne med True og False kan brukes direkte som filter. Sortert stigende kommer Ada først, og indeksen følger radene.
ExerciseKarakter fra poeng
Poengene på en prøve skal gjøres om til karakter: under \(10\) gir 1, \(10\)–\(19\) gir 2, \(20\)–\(29\) gir 3, \(30\)–\(39\) gir 4, \(40\)–\(49\) gir 5, og \(50\) eller mer gir 6.
Hvorfor kan du ikke bare skrive karakter(prove["poeng"])?
AnswerFasit
if poeng >= 50 krever ett tall. Med en hel Series blir sammenligningen en Series med True og False, og if vet ikke om den er sann (ValueError). apply kaller funksjonen med én verdi om gangen.
Kodeoppgaver
ExerciseLange turer
Skriv funksjonen lange(tabell, grense) som gir radene der km er større enn grense.
tabell[tabell["km"] > grense]
ExerciseTopp tre
Skriv funksjonen topp3(tabell, kolonne) som gir de tre radene med størst verdi i kolonnen, med den største først. Indeksen skal gå fra \(0\).
sort_values(kolonne, ascending=False), så head(3) og reset_index(drop=True).
ExerciseLegg til fart
Skriv funksjonen med_fart(tabell) som gir en kopi av tabellen med den nye kolonnen fart (km/t), regnet ut fra km og minutter og avrundet til én desimal.
Minutter delt på \(60\) gir timer. Lag en kopi med tabell.copy() først, og bruk round(1).
ExerciseFinn feilen: løpeturer i september
Funksjonen skal gi løpeturene som er minst \(5\) km lange, men gir en feilmelding. Rett den.
Bruk & i stedet for and, og sett parentes rundt hver betingelse.
Utfordringer
ExerciseKategorier med apply
Skriv funksjonen med_lengde(tabell) som gir en kopi av tabellen med kolonnen lengde: "kort" for under \(5\) km, "middels" for \(5\) til under \(15\) km og "lang" for \(15\) km eller mer. Sorter så resultatet etter km, med den lengste først, og la indeksen gå fra \(0\).
Skriv en hjelpefunksjon med if/elif/else og bruk apply på kolonnen km. Husk copy(), sort_values og reset_index(drop=True).
ExerciseAnalysen som oppskrift
En venn har skrevet denne koden i et regneark: filtrer på løping, sorter på dato, legg til en kolonne med fart, og kopier de fem siste radene til et nytt ark. Hver uke gjør hun det på nytt for hånd. Skriv det som én funksjon i pandas, og forklar hvorfor det er bedre enn å gjøre det for hånd. Datoene er tekst på formen "2026-09-03".
Datoer på formen år-måned-dag sorteres riktig som tekst, siden året står først. (Med "03.09" ville det blitt feil på tvers av måneder.) Funksjonen gjør det samme hver gang, så du slipper å gjøre feil når du klikker og kopierer. Den kan kjøres på nye data med én linje, og andre kan lese nøyaktig hva som er gjort. Det er en stor fordel når noen spør hvordan du kom fram til tallene.
Bruk &, | og ~ med parentes rundt hver betingelse, ikke and og or.
Indeksen følger radene når du filtrerer og sorterer. Bruk iloc[0] for den første raden.
9.3 Utforskende analyse
Når dataene er vasket, kan du begynne å stille spørsmål. Hva er typisk? Hvor mye varierer det? Er det forskjell på gruppene? Denne seksjonen handler om å beskrive data med noen få tall, og om å dele dataene i grupper og sammenligne dem.
9.3.1 Beskrivende statistikk
En klasse har registrert hvor mange timer de bruker på mobilen en vanlig dag. En avis skriver at «elevene bruker over fem timer på mobilen hver dag». Ser du på tallene, bruker de fleste fire eller fem timer, og bare én elev bruker mer enn sju. Avisa har ikke regnet feil, men den har valgt et tall som gir et litt annet bilde enn tallene viser.
Beskrivende statistikk er noen få tall som oppsummerer mange: hva som er typisk, og hvor mye det varierer. Du kjenner flere av dem fra matematikken. Her lærer du å regne dem ut med pandas, og å velge det tallet som gir et riktig bilde.
Læringsmål
Etter dette delkapittelet skal du kunne
regne ut og tolke gjennomsnitt, median og typetall,
beskrive spredning med variasjonsbredde, kvartiler og standardavvik,
bruke describe() og value_counts() for å få oversikt over en tabell,
velge det målet som gir et riktig bilde av dataene, og forklare valget.
Hva er typisk?
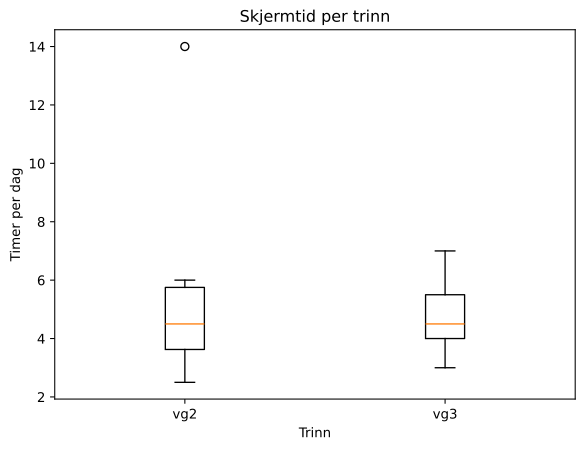
Her er skjermtiden til \(11\) elever, i timer per dag:
list("ABCDEFGHIJK") gir en liste med én bokstav per elev. Det er tre vanlige mål på hva som er typisk:
Gjennomsnittet (mean) er summen delt på antallet: \(59 / 11 \approx 5{,}36\).
Medianen (median) er tallet i midten når verdiene er sortert. Med \(11\) verdier er det nummer \(6\), altså \(4{,}5\). Med et partall antall verdier er medianen snittet av de to i midten.
Typetallet (mode) er verdien som forekommer flest ganger, her \(4{,}0\). Det kan være flere, så mode() gir en Series.
Gjennomsnittet er nesten én time høyere enn medianen. Det er eleven med \(14\) timer som drar det opp. En slik verdi, langt unna de andre, kalles en uteligger. Gjennomsnittet tar hensyn til hvor store alle verdiene er, så én ekstrem verdi flytter det mye. Medianen bryr seg bare om rekkefølgen, så den flytter seg nesten ikke. Det var gjennomsnittet avisa brukte.
Gjennomsnittet påvirkes mye av uteliggere. Medianen gjør det ikke. Når dataene er skjeve (noen få er mye større eller mindre enn resten), gir medianen ofte et bedre bilde av hva som er typisk.
EksempelLønn i en liten bedrift
En bedrift har fem ansatte som tjener \(500\,000\), \(520\,000\), \(550\,000\), \(580\,000\) og \(3\,000\,000\) kroner (sjefen). Regn ut gjennomsnitt og median. Hvilket tall vil du bruke i en stillingsannonse, og hvilket gir et riktig bilde?
HintHint
Legg tallene i en Series og bruk mean() og median().
Gjennomsnittet er \(1\,030\,000\), medianen \(550\,000\). Bedriften vil kanskje skrive «snittlønn over én million» i annonsen, men fire av fem tjener rundt en halv million. Medianen gir et riktig bilde av hva en vanlig ansatt tjener.
Hvor mye varierer det?
To klasser kan ha samme snitt og likevel være helt ulike. I den ene bruker alle rundt fem timer, i den andre bruker noen én time og andre ti. Vi trenger også et mål på spredning.
Det enkleste er variasjonsbredden, forskjellen mellom største og minste verdi:
print(timer.max() - timer.min())
11.5
Variasjonsbredden er \(11{,}5\) timer, men den er bestemt av bare to verdier, og den ene er uteliggeren. Kvartilene deler de sorterte dataene i fire like store deler. Den nedre kvartilen (\(Q_1\)) har en fjerdedel av verdiene under seg, og den øvre (\(Q_3\)) har tre fjerdedeler under seg. Medianen er den midterste, \(Q_2\):
Halvparten av elevene ligger mellom \(3{,}75\) og \(5{,}75\) timer. Forskjellen, \(Q_3 - Q_1 = 2\) timer, kalles kvartilbredden. Den sier hvor spredt den midterste halvdelen er, og påvirkes ikke av uteliggeren.
Standardavviket (std) sier omtrent hvor langt fra gjennomsnittet en typisk verdi ligger:
print(round(timer.std(), 2))
3.16
Mange verdier nær snittet gir et lite standardavvik, og verdier langt unna gir et stort. Standardavviket bruker gjennomsnittet, så også det påvirkes av uteliggere. Uten eleven med \(14\) timer er det bare omtrent \(1{,}4\). (pandas regner standardavviket for et utvalg og deler på \(n - 1\). Det er det samme som i matematikken når dataene er et utvalg.)
Variasjonsbredden og standardavviket påvirkes av uteliggere. Kvartilbredden \(Q_3 - Q_1\) gjør det ikke. Bruk median og kvartiler sammen, og gjennomsnitt og standardavvik sammen.
EksempelTo klasser
Klasse A har poengene \(10, 11, 12, 13, 14\), og klasse B har \(2, 7, 12, 17, 22\). Sammenlign snitt og standardavvik. Hva sier tallene?
Begge klassene har snitt \(12\). Standardavviket er \(1{,}58\) i A og \(7{,}91\) i B. I A presterte alle omtrent likt. I B er forskjellene store, og det er viktig for en lærer å vite, selv om snittet er det samme.
Overblikk med describe og value_counts
describe() gir alle de vanligste tallene for en tallkolonne på én gang:
timer.describe().round(2)
count    11.00
mean      5.36
std       3.16
min       2.50
25%       3.75
50%       4.50
75%       5.75
max      14.00
Name: timer, dtype: float64
count er antall verdier som finnes, 50% er medianen, og 25% og 75% er kvartilene. Bruker du describe() på en hel tabell, får du en kolonne for hver tallkolonne. Det er ofte det første du gjør etter at du har lest inn og vasket en tabell.
For en kolonne med kategorier, som trinn, gir gjennomsnitt ingen mening. Der teller vi hvor mange det er av hver med value_counts(), og med normalize=True får du andelen i stedet for antallet:
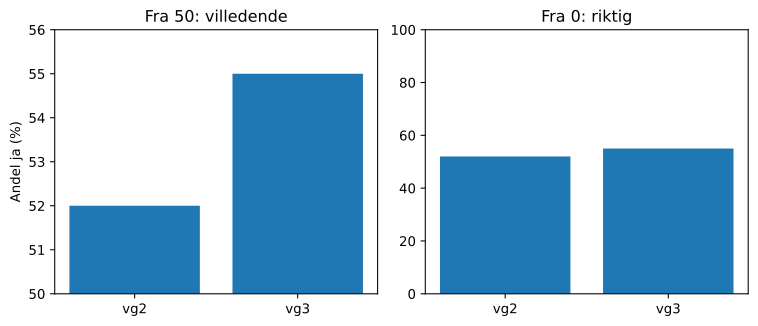
Seks av elevene går på vg2, og det er \(55\) %. Typetallet for en kategori er den som har høyest antall.
RegelVelge mål
Data
Typisk
Spredning
Tall, jevnt fordelt
mean()
std()
Tall med uteliggere
median()
kvartiler
Kategorier
typetall
value_counts()
Se alltid på dataene og describe() før du velger. Er gjennomsnittet og medianen svært ulike, er det skjeve data eller uteliggere.
EksempelHva er best å oppgi?
Hvilket mål på «typisk» passer best? a) Boligpriser i en kommune med noen få luksushus. b) Høyden til elevene i en klasse. c) Hvilket mobilmerke elevene har.
HintHint
Er det uteliggere? Er det tall eller kategorier?
LosningLøsning
Medianen. Noen få svært dyre hus drar gjennomsnittet opp, så medianen viser bedre hva en vanlig bolig koster. Det er derfor statistikk om boligpriser og lønn ofte bruker medianen.
Gjennomsnittet. Høyder er jevnt fordelt uten ekstreme uteliggere, så gjennomsnitt og median blir omtrent like.
Typetallet. Mobilmerke er en kategori, så du kan ikke regne snitt. Det vanligste merket, og andelen med value_counts(normalize=True), beskriver dataene.
AdvarselVanlige feil
Du oppgir gjennomsnittet uten å se etter uteliggere. Sammenlign alltid med medianen.
Du regner snitt av kategorier som er kodet som tall, for eksempel postnummer eller trinn (\(2\) og \(3\)). Tallet gir ingen mening.
Du glemmer at mode() gir en Series. Bruk mode().tolist() eller mode().iloc[0].
Du skriver quantile(25) i stedet for quantile(0.25). Kvartilen gis som en andel mellom \(0\) og \(1\).
Du sammenligner bare snittet for to grupper, og overser at spredningen er helt ulik.
Du fjerner uteliggere bare fordi de er store. En uteligger kan være en feil, men den kan også være ekte og viktig. Sjekk hva den er før du fjerner den.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseRegn ut for hånd
Antall mål en spiller scoret i sju kamper: \(0, 2, 1, 0, 3, 0, 1\).
Gjennomsnittet
Medianen
Typetallet
Variasjonsbredden
ExerciseLes av describe
En kolonne med reisetid til skolen (i minutter) ga dette:
count    120.0
mean      24.3
std       15.8
min        2.0
25%       12.0
50%       20.0
75%       31.0
max       95.0
Hvor mange elever er med?
Hva er medianen?
Hva er kvartilbredden?
Hvor mange elever bruker omtrent mer enn \(31\) minutter?
ExerciseHvilket tall passer?
Hvilket mål ville du brukt i hvert tilfelle, og hvorfor?
Hvor lenge en vanlig elev bruker på leksene, når noen få bruker ekstremt lang tid.
AnswerFasit
Medianen, siden den ikke påvirkes av de få som bruker ekstremt lang tid.
Hvilken buss flest elever tar til skolen.
AnswerFasit
Typetallet, eller value_counts(), siden bussrute er en kategori.
Hvor jevnt laget presterer i en sesong (antall mål per kamp).
AnswerFasit
Et spredningsmål, for eksempel standardavviket. Lite standardavvik betyr at laget scorer omtrent like mye hver kamp.
Nivå 2
ExerciseUteliggeren
Bruk skjerm-tabellen fra teorien.
Hva blir gjennomsnittet hvis vi fjerner eleven med \(14\) timer?
Sortert er verdiene \(1, 2, 3, 5, 8, 8, 8\), så medianen er \(5\). Typetallet er \(8\), og det forekommer \(3\) ganger (value_counts() sorterer det vanligste først). Snittet er \(35 / 7 = 5\), og tre verdier er større enn \(5\).
Regn ut gjennomsnitt, median og standardavvik for begge.
AnswerFasit
k1: snitt \(25\), median \(26\), standardavvik \(3{,}35\). k2: snitt \(25\), median \(29\), standardavvik \(13{,}54\).
Beskriv forskjellen på klassene med ord.
AnswerFasit
Klassene har samme gjennomsnitt, men i k1 ligger alle nær snittet, mens k2 har store forskjeller. Der har to elever svært lave poeng (\(5\) og \(12\)), mens de fleste andre gjorde det bedre enn noen i k1. Medianen er høyere enn snittet i k2, fordi de to lave trekker snittet ned. Læreren bør følge opp de to i k2 som strevde.
Kodeoppgaver
ExerciseSammendrag
Skriv funksjonen sammendrag(s) som tar en Series med tall og gir en ordbok med nøklene "snitt", "median", "min" og "maks". Snittet skal være avrundet til to desimaler.
s.mean(), s.median(), s.min() og s.max(). Bruk round(..., 2) på snittet.
ExerciseKvartilbredde
Skriv funksjonen kvartilbredde(s) som gir \(Q_3 - Q_1\) for en Series.
s.quantile(0.75) - s.quantile(0.25)
ExerciseAndel per kategori
Skriv funksjonen andel_prosent(s) som tar en Series med kategorier og gir en ordbok med andelen av hver kategori i prosent, avrundet til én desimal.
value_counts(normalize=True) gir andeler mellom \(0\) og \(1\). Gang med \(100\), rund av og bruk to_dict().
ExerciseFinn feilen: medianen
Funksjonen skal gi medianen, men gir feil svar. Rett den.
Funksjonen sorterer ikke, og den virker bare med et oddetall antall verdier. pandas har en metode som gjør jobben.
Utfordringer
ExerciseFinn uteliggere
En vanlig regel sier at en verdi er en uteligger hvis den ligger mer enn \(1{,}5\) kvartilbredder under \(Q_1\) eller over \(Q_3\). Skriv funksjonen uteliggere(s) som gir en liste med uteliggerne, sortert stigende.
Regn ut q1, q3 og iqr = q3 - q1. Filtrer med (s < q1 - 1.5 * iqr) | (s > q3 + 1.5 * iqr), sorter og bruk tolist().
ExerciseStatistikk som lurer
Et firma skriver: «Kundene våre sparer i snitt \(4000\) kroner i året.» Hvilke spørsmål bør du stille før du tror på det? Bruk det du har lært om gjennomsnitt, median og spredning.
AnswerFasit
Hva er medianen? Kanskje noen få kunder sparte svært mye, og de fleste sparte lite eller ingenting. Hvor stor er spredningen? Hvor mange kunder er med, og hvordan er de valgt? Hvis bare fornøyde kunder har svart, er snittet for høyt (se «Når hullene ikke er tilfeldige» i 9.2.1). Hva er sammenlignet med, og hvem har regnet ut tallet? Et snitt uten median og spredning sier lite om hva du kan forvente.
Gjennomsnitt og standardavvik påvirkes av uteliggere. Median og kvartiler gjør det ikke.
Er snitt og median svært ulike, er dataene skjeve. Oppgi gjerne begge.
9.3.2 Gruppering med groupby
Elevrådet driver en kiosk og har ført opp salget hver dag. Nå vil de vite hvilken vare som tjener mest, og hvilken dag det er mest å gjøre. Ett snitt for hele tabellen svarer ikke på det. De må dele salget opp etter vare, regne ut summen for hver vare, og sammenligne.
Det er nesten alltid slik analyser blir interessante: du sammenligner grupper. Snittkarakter per klasse, temperatur per måned, salg per vare. I SQL gjorde du det med GROUP BY (8.3.2). I pandas heter det groupby.
Læringsmål
Etter dette delkapittelet skal du kunne
forklare splitt–anvend–kombiner,
gruppere en tabell på én kolonne med groupby og regne ut sum, snitt og antall per gruppe,
regne ut flere mål på én gang med agg, og sortere resultatet,
gruppere på to kolonner, og gjøre resultatet om til en vanlig tabell med reset_index.
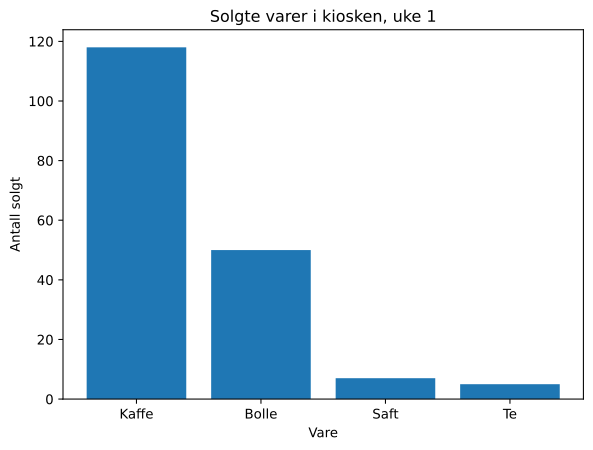
Les linja fra venstre: «grupper kiosken etter vare, ta kolonnen antall, og summer». Resultatet er en Series der indeksen er varene, sortert alfabetisk. Kaffe er solgt \(118\) ganger, Bolle \(50\).
Du kan bruke alle statistikkmetodene fra 9.3.1 på gruppene: sum(), mean(), median(), min(), max(), count() og std(). size() teller rader per gruppe og trenger ingen kolonne:
groupby deler radene i grupper etter verdiene i en kolonne (splitt), regner ut noe for hver gruppe (anvend), og setter svarene sammen (kombiner). Resultatet har én rad per gruppe, med gruppene som indeks.
EksempelMat eller drikke?
Hva gir mest inntekt, mat eller drikke? Hva er snittprisen i hver kategori?
HintHint
Grupper på kategori. Ta sum() av inntekt og mean() av pris.
LosningLøsning
kat = kiosk.groupby("kategori")print(kat["inntekt"].sum())print(kat["pris"].mean())
kategori
Drikke    2561
Mat       1250
Name: inntekt, dtype: int64
kategori
Drikke    18.833333
Mat       25.000000
Name: pris, dtype: float64
Drikke gir mest: \(2561\) kroner mot \(1250\) for mat, selv om snittprisen er lavere (\(18{,}8\) mot \(25{,}0\)). Det selges mye mer drikke. Merk at snittprisen her er snittet av radene, ikke vektet etter antall solgte.
Flere mål og sortering
Vil du ha flere tall per gruppe, bruker du agg med en liste:
Nå får du en tabell. count er antall dager varen er registrert, og mean er snittet per dag. Te og Saft er bare registrert én dag hver, så snittet for dem bygger på bare én måling.
Vil du ha ulike mål for ulike kolonner, gir du en ordbok:
Nå er det en vanlig tabell igjen, som du kan filtrere, sortere og tegne. reset_index() er like nyttig etter gruppering på én kolonne, når du vil ha gruppene som en kolonne.
Legg merke til at dagene står i alfabetisk rekkefølge (man, ons, tir, tor), ikke i ukerekkefølge. pandas vet ikke at «tir» kommer før «ons». Vil du ha riktig rekkefølge, kan du for eksempel bruke tall for dagene, eller datoer.
RegelGrupper på to kolonner
g = t.groupby(["a", "b"])["verdi"].sum()g.reset_index() # gruppene blir kolonner
Med en liste av kolonner får du én rad per kombinasjon. reset_index() gjør indeksen om til vanlige kolonner igjen.
EksempelAntall registreringer per dag og kategori
Hvor mange rader er det for hver kombinasjon av dag og kategori? Lag en vanlig tabell med kolonnene dag, kategori og rader.
HintHint
Bruk size() etter groupby med to kolonner, og reset_index(name="rader") for å gi tallkolonnen et navn.
size() gir en Series uten navn, så reset_index(name="rader") gir tallkolonnen navnet rader. Onsdag har to drikkevarer (kaffe og saft) og én matvare.
AdvarselVanlige feil
Du glemmer å velge kolonne og skriver t.groupby("a").mean(). Da prøver pandas å ta snittet av alle kolonnene, også tekst, og det gir feil. Velg kolonnen: t.groupby("a")["b"].mean().
Du blander count() og sum(). count() teller rader, sum() legger sammen verdiene.
Du leter etter gruppenavnet som en kolonne, men det er i indeksen. Bruk reset_index() eller idxmax().
Du sammenligner snittet for grupper som har svært ulikt antall rader, uten å ta med antallet.
Du forventer at gruppene står i en naturlig rekkefølge (ukedager, måneder). De sorteres alfabetisk.
Snitt av snitt: Snittet av snittene for to klasser er ikke snittet for alle elevene hvis klassene har ulik størrelse.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
I oppgavene under er kiosk tabellen fra teorien, med kolonnen inntekt.
Hver linje gir feil eller et svar som ikke svarer på spørsmålet. Forklar og rett.
Snittet av antall per dag: kiosk.groupby("dag").mean()
AnswerFasit
Uten valgt kolonne prøver pandas å ta snittet av alle kolonnene, også vare og kategori, som er tekst. Det gir TypeError. Rett: kiosk.groupby("dag")["antall"].mean().
Hvor mange varer som er solgt per dag: kiosk.groupby("dag")["antall"].count()
AnswerFasit
count() teller rader, ikke solgte varer. Rett: kiosk.groupby("dag")["antall"].sum().
Navnet på dagen med høyest inntekt: kiosk.groupby("dag")["inntekt"].sum().max()
AnswerFasit
max() gir det høyeste tallet, ikke dagen. Rett: .idxmax(), som gir "ons".
Klasse A har \(10, 30, 50\) (snitt \(30\)), og B har \(20, 40\) (snitt \(30\)). Her er snittet for alle også \(30\), men det er tilfeldig. Med andre tall blir snittet av snittene og snittet for alle forskjellige når gruppene har ulik størrelse.
ExerciseSnitt av snitt
Klasse A har \(10\) elever med snitt \(4{,}0\). Klasse B har \(30\) elever med snitt \(3{,}0\).
Hva er snittet av de to snittene?
Hva er det riktige snittet for alle \(40\) elevene?
Hvorfor blir de forskjellige?
Kodeoppgaver
ExerciseSum per gruppe
Skriv funksjonen sum_per(tabell, gruppe, verdi) som gir en ordbok med summen av verdi for hver gruppe i kolonnen gruppe.
tabell.groupby(gruppe)[verdi].sum() gir en Series. to_dict() gjør den om til en ordbok.
ExerciseBeste gruppe
Skriv funksjonen beste(tabell, gruppe, verdi) som gir navnet på gruppa med størst sum av verdi.
Grupper og summer, og bruk idxmax() for å få navnet på gruppa.
ExerciseStatistikk per klasse
Skriv funksjonen per_klasse(tabell) som tar en tabell med kolonnene klasse og poeng, og gir en DataFrame med kolonnene klasse, snitt og antall, sortert med høyeste snitt først. Snittet skal være avrundet til én desimal, og indeksen skal gå fra \(0\).
agg(snitt="mean", antall="count") på kolonnen poeng gir kolonner med de navnene du velger. Bruk så reset_index(), sort_values og round(1).
ExerciseFinn feilen: antall solgte
Funksjonen skal gi hvor mange varer som er solgt hver dag, men svaret er feil. Rett den.
Hva er forskjellen på count() og sum()?
Utfordringer
ExerciseAndel av inntekten
Skriv funksjonen andel_inntekt(tabell) som tar en tabell med kolonnene vare og inntekt, og gir en ordbok med hvor mange prosent av den totale inntekten hver vare står for, avrundet til én desimal.
Summer inntekten per vare, del på tabell["inntekt"].sum() og gang med \(100\).
Exercisegroupby og SQL
I 8.3.2 skrev du SQL med GROUP BY. Skriv pandas-koden som gjør det samme som spørringen, og forklar hva hver del svarer til.
WHERE er filteret (9.2.2), GROUP BY vare er groupby("vare"), SUM(antall) er ["antall"].sum(), og ORDER BY ... DESC er sort_values(ascending=False). Resultatet er Kaffe \(118\), Saft \(7\) og Te \(5\). Det er de samme ideene i to språk. SQL brukes når dataene ligger i en database, pandas når de er lest inn i Python.
s = t.groupby("g")["v"].sum()s.sort_values(ascending=False)s.idxmax()
To kolonner
g = t.groupby(["a", "b"])["v"]g.sum().reset_index()
Velg alltid kolonnen før du regner: groupby("g")["v"].
count() teller rader, sum() legger sammen. Gruppene havner i indeksen.
9.4 Visualisering
En tabell med tusen rader sier lite når du ser på den. Et diagram viser mønstre, trender og uteliggere med én gang. Denne seksjonen handler om å tegne diagrammer i Python, og om å velge et diagram som får fram det du vil vise, uten å lure den som ser på det.
9.4.1 Diagrammer med matplotlib
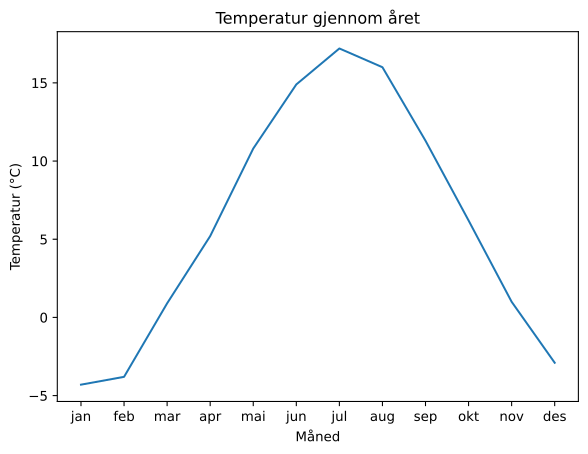
Her er gjennomsnittstemperaturen i en by for hver måned: \(-4{,}3\), \(-3{,}8\), \(0{,}9\), \(5{,}2\), \(10{,}8\), \(14{,}9\), \(17{,}2\), \(16{,}0\), \(11{,}3\), \(6{,}2\), \(1{,}0\) og \(-2{,}9\) grader. Ser du at juli er varmest, og at våren går raskere enn høsten? Kanskje, hvis du leser nøye. Tegnet som en linje ser du det med én gang.
matplotlib er det mest brukte biblioteket for diagrammer i Python. Det kan tegne nesten alt, og har derfor mange innstillinger. Her lærer du ett fast mønster og de fire diagrammene du trenger oftest.
Læringsmål
Etter dette delkapittelet skal du kunne
tegne et diagram med fig, ax = plt.subplots() og gi det tittel og navn på aksene,
tegne linjediagram, søylediagram, histogram og spredningsdiagram,
tegne flere dataserier i samme diagram med forklaring (legend),
lagre et diagram som en bildefil.
Det første diagrammet
Alle diagrammene i boka lages med det samme mønsteret:
import matplotlib.pyplot as plt er en fast vane, som pd for pandas. Så:
fig, ax = plt.subplots() lager en figur (fig) med ett diagram (ax, fra engelsk axes). Figuren er hele bildet, og ax er diagrammet du tegner i.
ax.plot(x, y) tegner en linje gjennom punktene. x og y må ha like mange verdier.
set_title, set_xlabel og set_ylabel gir tittel og navn på aksene. Ta alltid med enheten, som «(°C)».
plt.show() viser diagrammet. I en notatbok vises det også uten, men i et vanlig Python-program i VS Code åpnes det i et eget vindu først når du kaller plt.show().
Du kan gi x og y som lister eller som kolonner fra en tabell. Med en Series fra en gruppering kan du bruke indeksen som x: ax.plot(s.index, s.values).
DefinisjonMønsteret for et diagram
import matplotlib.pyplot as pltfig, ax = plt.subplots()ax.plot(x, y)ax.set_title("Tittel")ax.set_xlabel("x (enhet)")ax.set_ylabel("y (enhet)")plt.show()
Et diagram skal alltid ha tittel og navn på aksene, med enhet.
EksempelNedbør gjennom året
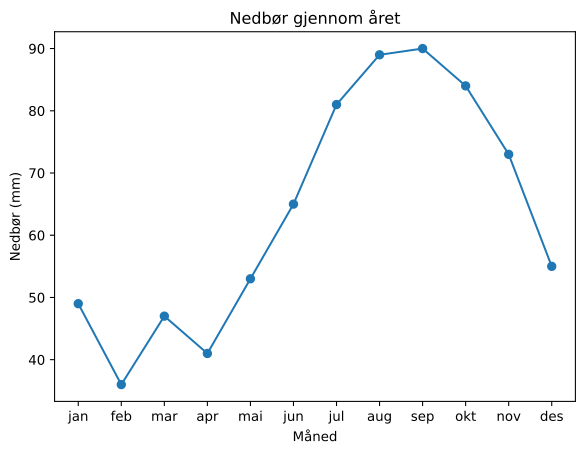
Nedbøren i byen er \(49\), \(36\), \(47\), \(41\), \(53\), \(65\), \(81\), \(89\), \(90\), \(84\), \(73\) og \(55\) mm. Tegn den som et linjediagram med punkter i hver måned.
HintHint
Bruk mønsteret over. ax.plot(x, y, marker="o") setter en prikk på hvert punkt.
Det er lettere å sammenligne søylene når de er sortert. Har kategoriene lange navn, bruker du ax.barh for liggende søyler.
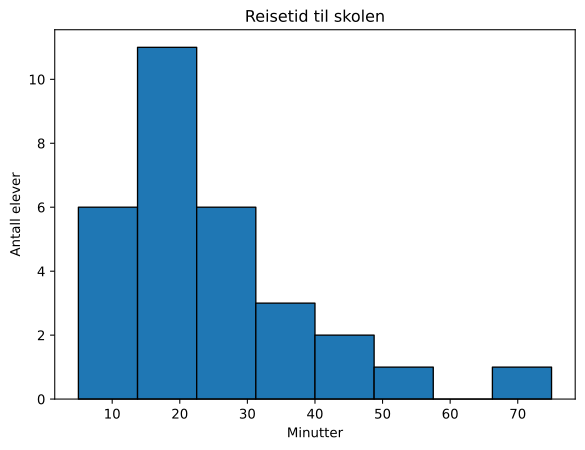
Et histogram (ax.hist) ser likt ut, men viser noe annet. Det tar én tallkolonne, deler tallene i intervaller og viser hvor mange verdier som havner i hvert. Det viser fordelingen: hvor de fleste ligger, hvor spredt det er, og om det er uteliggere. Her er reisetiden til \(30\) elever:
bins=8 deler tallene fra \(5\) til \(75\) i åtte like brede intervaller. De fleste bruker mellom \(10\) og \(30\) minutter, og fordelingen har en lang «hale» mot høyre, med én elev på \(75\) minutter. Det er slike skjeve data der medianen er bedre enn gjennomsnittet (9.3.1). Prøv med flere og færre bins og se hvordan bildet endrer seg.
Et søylediagram sammenligner tall for kategorier. Et histogram viser fordelingen av én tallkolonne.
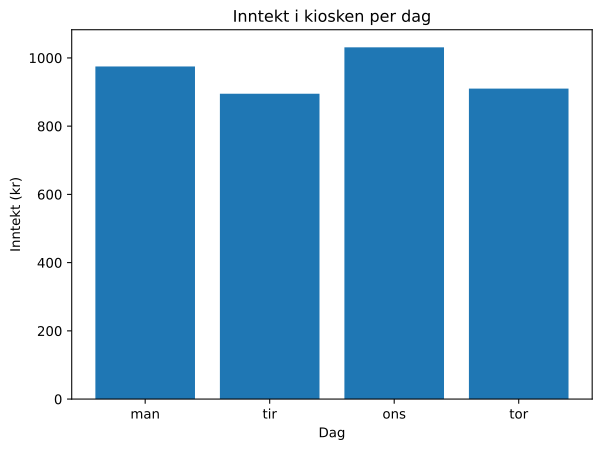
EksempelInntekt per dag
Tegn et søylediagram med inntekten i kiosken per dag. Dagene skal stå i riktig rekkefølge (man, tir, ons, tor).
HintHint
Grupper på dag og summer inntekt. Gruppene blir sortert alfabetisk, så bruk reindex med en liste for å få riktig rekkefølge.
LosningLøsning
per_dag = kiosk.groupby("dag")["inntekt"].sum()per_dag = per_dag.reindex(["man", "tir", "ons", "tor"])fig, ax = plt.subplots()ax.bar(per_dag.index, per_dag.values)ax.set_title("Inntekt i kiosken per dag")ax.set_xlabel("Dag")ax.set_ylabel("Inntekt (kr)")plt.show()
reindex setter radene i den rekkefølgen du gir. Uten den ville onsdag stått før tirsdag. Her er rekkefølgen viktig, fordi den som leser, forventer ukedagene i rekkefølge.
Spredningsdiagram og flere serier
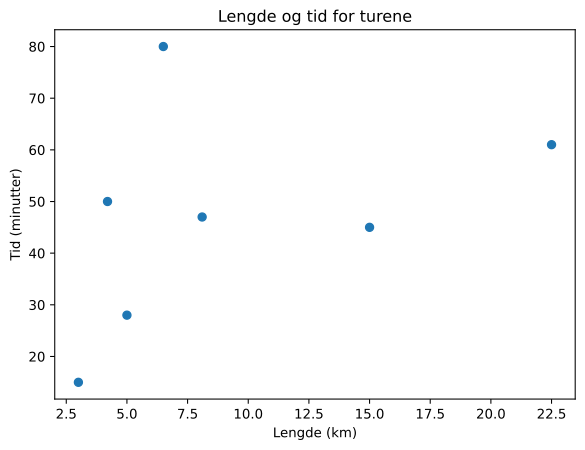
Et spredningsdiagram (ax.scatter) tegner ett punkt per rad, med én tallkolonne langs hver akse. Det viser om to størrelser henger sammen. Her er turene fra 9.2.2:
fig, ax = plt.subplots()ax.scatter(turer["km"], turer["minutter"])ax.set_title("Lengde og tid for turene")ax.set_xlabel("Lengde (km)")ax.set_ylabel("Tid (minutter)")plt.show()
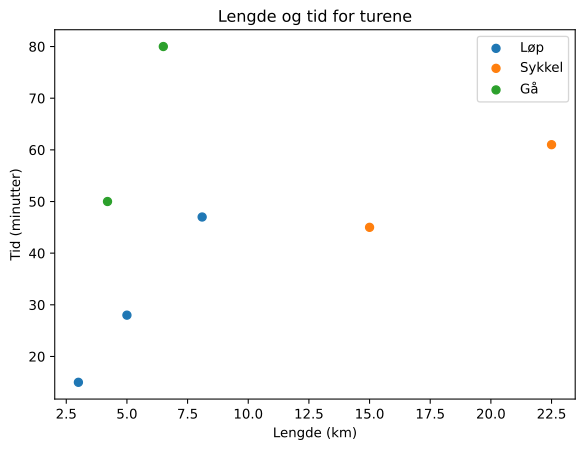
Lengre turer tar lengre tid, men ikke for alle: to av punktene ligger høyt selv om turene er korte. Det er gåturene. Vi ser at aktiviteten betyr mye. Det får vi tydelig fram ved å tegne hver aktivitet for seg, med en forklaring (legend):
fig, ax = plt.subplots()for akt in ["Løp", "Sykkel", "Gå"]: del_t = turer[turer["aktivitet"] == akt] ax.scatter(del_t["km"], del_t["minutter"], label=akt)ax.set_title("Lengde og tid for turene")ax.set_xlabel("Lengde (km)")ax.set_ylabel("Tid (minutter)")ax.legend()plt.show()
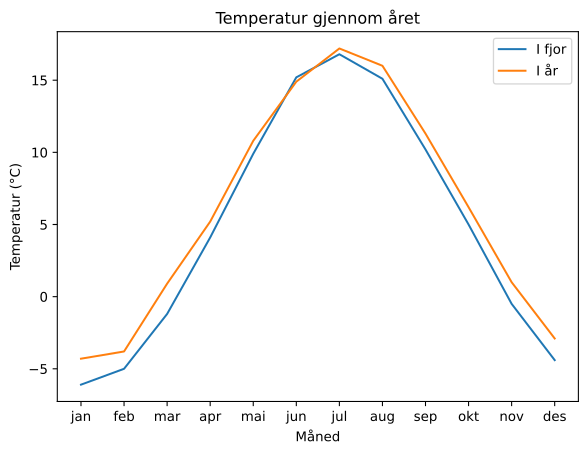
Hver gang du tegner i den samme ax, kommer det nye oppå det gamle, i en ny farge. label gir serien et navn, og ax.legend() viser navnene i en boks. Det samme virker med plot, for eksempel for å tegne temperaturen for to år i samme linjediagram.
Til slutt: Vil du bruke diagrammet i en rapport eller presentasjon, lagrer du det med fig.savefig("turer.png") før plt.show(). Filtypen bestemmes av navnet (.png, .svg eller .pdf), og dpi=200 gir skarpere bilder.
RegelSpredningsdiagram og flere serier
ax.scatter(x, y) # ett punkt per radax.plot(x, y1, label="A")ax.plot(x, y2, label="B")ax.legend() # forklaringfig.savefig("diagram.png", dpi=200)
EksempelTo år i samme diagram
Temperaturen i fjor var \(-6{,}1\), \(-5{,}0\), \(-1{,}2\), \(4{,}1\), \(9{,}9\), \(15{,}2\), \(16{,}8\), \(15{,}1\), \(10{,}2\), \(5{,}0\), \(-0{,}5\) og \(-4{,}4\) grader. Tegn den sammen med temp fra teorien, med forklaring.
HintHint
Kall ax.plot to ganger med label, og avslutt med ax.legend().
I år var varmere enn i fjor i nesten alle månedene, mest om vinteren. Bare i juni var det kaldere. Uten forklaringen kunne ingen sett hvilken linje som er hvilket år.
AdvarselVanlige feil
Du glemmer tittel, navn på aksene eller enhet. Den som leser, må da gjette hva diagrammet viser.
x og y har ulikt antall verdier. Det gir ValueError: x and y must have same first dimension.
Du bruker label men glemmer ax.legend(), så forklaringen vises ikke.
Du lagrer med savefigetterplt.show(). Da kan bildet bli tomt, fordi figuren er lukket.
Du bruker histogram når du vil sammenligne kategorier, eller søylediagram når du vil vise en fordeling.
I VS Code skjer det ingenting fordi plt.show() mangler.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseHvilken metode?
Hvilken metode på ax bruker du?
Antall elever på hvert programfag, som stående søyler.
AnswerFasit
ax.bar
Antall besøkende på en nettside hver dag i en måned.
AnswerFasit
ax.plot (utvikling over tid)
Fordelingen av høyden til \(200\) elever.
AnswerFasit
ax.hist
Sammenhengen mellom antall timer øving og poeng på en prøve.
x har fire verdier og y tre, så det gir ValueError. Gi like mange verdier. ax.legend() har ingenting å vise, siden ingen serie har label, så matplotlib gir en advarsel. Gi linjen label="...", eller fjern legend. Diagrammet mangler også tittel og navn på aksene.
Nivå 2
ExerciseHva viser histogrammet?
Et histogram over hvor mange timer elevene sover har høyeste søyle ved \(7\)–\(8\) timer, en lang hale ned mot \(4\) timer og nesten ingen over \(9\) timer.
Er gjennomsnittet høyere eller lavere enn medianen? Begrunn.
AnswerFasit
Lavere. Halen mot venstre (de som sover lite) trekker gjennomsnittet ned, mens medianen påvirkes lite.
Hvilket mål ville du brukt for å beskrive en typisk elev?
AnswerFasit
Medianen, siden fordelingen er skjev. Oppgi gjerne kvartilene også.
ExerciseFra tabell til diagram
Lag et søylediagram over inntekten per vare i kiosken, med den største først. Skriv koden, og forklar hvorfor du bruker søylediagram og ikke linjediagram.
Varene er kategorier uten noen naturlig rekkefølge. En linje mellom dem ville antydet at det er en utvikling fra Kaffe til Bolle, og det gir ingen mening. Linjediagram passer når x-aksen er tid eller en annen størrelse som henger sammen.
ExerciseFlere linjer
Skriv koden som tegner antall solgte kaffe og boller per dag (man–tor) som to linjer i samme diagram, med forklaring. Bruk tallene fra kiosk.
HintHint
Filtrer på hver vare, grupper på dag, og bruk reindex(["man", "tir", "ons", "tor"]). Både kaffe og boller er solgt alle fire dagene.
AnswerFasit
dager = ["man", "tir", "ons", "tor"]fig, ax = plt.subplots()for vare in ["Kaffe", "Bolle"]: del_t = kiosk[kiosk["vare"] == vare] s = del_t.groupby("dag")["antall"].sum() s = s.reindex(dager) ax.plot(dager, s.values, marker="o", label=vare)ax.set_title("Salg per dag")ax.set_xlabel("Dag")ax.set_ylabel("Antall solgt")ax.legend()plt.show()
Kaffe er \(30\), \(26\), \(34\) og \(28\), og boller \(12\), \(15\), \(9\) og \(14\).
Kodeoppgaver
I disse oppgavene skal funksjonen lage diagrammet og gi ax tilbake (med return ax). Testene sjekker hva som er tegnet, så du trenger ikke plt.show().
ExerciseLinjediagram
Skriv funksjonen tegn_linje(x, y, tittel) som tegner et linjediagram av x og y med tittelen tittel, og gir ax tilbake.
ax.plot(x, y) og ax.set_title(tittel).
ExerciseSøylediagram fra en gruppering
Skriv funksjonen tegn_sum(tabell, gruppe, verdi) som tegner et søylediagram med summen av verdi for hver gruppe. Navnet på x-aksen skal være gruppe, og navnet på y-aksen verdi.
Grupper og summer: s = tabell.groupby(gruppe)[verdi].sum(). Tegn med ax.bar(s.index, s.values).
ExerciseHistogram
Skriv funksjonen tegn_fordeling(tall, antall_bins) som tegner et histogram av tall med antall_bins intervaller, med y-aksen «Antall».
ax.hist(tall, bins=antall_bins) og ax.set_ylabel("Antall").
ExerciseFinn feilen: forklaringen mangler
Funksjonen skal tegne to linjer med navn i en forklaring, men forklaringen er tom. Rett den.
legend() viser bare serier som har fått label.
Utfordringer
ExerciseEtt punktsett per gruppe
Skriv funksjonen tegn_grupper(tabell, x, y, gruppe) som tegner et spredningsdiagram med ett punktsett (én farge) per verdi i kolonnen gruppe, sortert alfabetisk, med forklaring og navn på aksene (x og y).
Gå gjennom sorted(tabell[gruppe].unique()). Filtrer på hver verdi og kall ax.scatter(..., label=verdi). Avslutt med ax.legend().
ExerciseFlere diagrammer i én figur
plt.subplots(1, 2) lager en figur med to diagrammer ved siden av hverandre, og gir dem som et par: fig, (ax1, ax2) = plt.subplots(1, 2). Lag en figur med temperaturen som linjediagram til venstre og nedbøren som søylediagram til høyre. Når er det lurt å vise to diagrammer side om side i stedet for i samme diagram?
figsize gir bredde og høyde i tommer, og tight_layout() hindrer at teksten overlapper. Side om side er lurt når størrelsene har ulik enhet (grader og millimeter) eller ulik skala. I samme diagram ville den ene serien blitt flat, og y-aksen kunne bare hatt én enhet. Samme diagram passer når seriene har samme enhet og du vil sammenligne dem direkte, som temperaturen for to år.
Oppsummering
Mønsteret
import matplotlib.pyplot as pltfig, ax = plt.subplots()# tegn herax.set_title("...")ax.set_xlabel("...")ax.set_ylabel("...")plt.show()
savefig før plt.show(). Uten plt.show() vises ingenting i VS Code.
9.4.2 Velge riktig diagram
Elevrådet har spurt elevene om de vil ha lengre lunsj. \(52\) % av vg2 og \(55\) % av vg3 svarer ja. Tegner du det som to søyler der y-aksen starter på \(50\), ser søyla for vg3 ut til å være dobbelt så høy som for vg2. Tegnet fra \(0\) er de nesten like. Begge diagrammene viser de samme tallene, men bare det ene gir et riktig bilde.
I 9.4.1 lærte du å tegne fire diagrammer. Nå handler det om å velge riktig: hvilket diagram som svarer på spørsmålet ditt, og hvordan du tegner det slik at det ikke lurer noen, heller ikke deg selv.
Læringsmål
Etter dette delkapittelet skal du kunne
velge diagram ut fra spørsmålet: sammenligne, utvikling, fordeling eller sammenheng,
tegne og tolke et boksplott,
kjenne igjen og unngå villedende diagrammer,
lage diagrammer som er lette å lese for alle.
Spørsmålet bestemmer diagrammet
Start alltid med spørsmålet du vil svare på. Nesten alle spørsmål om data hører til én av fire typer:
Spørsmål
Diagram
Sammenligne kategorier
søyle (bar)
Utvikling over tid
linje (plot)
Fordeling av én størrelse
histogram, boksplott
Sammenheng mellom to størrelser
spredning (scatter)
Et nyttig triks er å se på hva som står på aksene. Er x-aksen kategorier uten rekkefølge (varer, klasser, land), passer søyler. Er den tid, passer en linje, fordi linjen viser at punktene henger sammen. Er det bare én tallkolonne, viser du fordelingen. Er det to tallkolonner, tegner du dem mot hverandre.
Kakediagram viser deler av en helhet, for eksempel hvor stor andel av budsjettet som går til hver ting. Det er vanlig, men vanskelig å lese: øyet er dårlig til å sammenligne vinkler og arealer, og med mer enn tre–fire biter blir det rotete. Et sortert søylediagram med andeler viser det samme tydeligere. Bruk kakediagram bare når det er få deler, og poenget er at én del er mye større enn resten.
RegelVelg diagram
Hva er spørsmålet? Sammenligne, utvikling, fordeling eller sammenheng?
Hva står på x-aksen? Kategorier → søyler. Tid → linje. Én tallkolonne → histogram eller boksplott. To tallkolonner → spredning.
Tegn, og spør: Svarer diagrammet på spørsmålet med én gang?
EksempelHvilket diagram?
Hvilket diagram passer? a) Hvordan har antall elever på skolen endret seg de siste ti årene? b) Hvilke fag har flest elever? c) Får de som trener mye, bedre karakter i kroppsøving?
HintHint
Se på hva som skal stå på x-aksen.
LosningLøsning
Linjediagram. x-aksen er år (tid), og vi vil se utviklingen.
Søylediagram, sortert med det største først. x-aksen er fag (kategorier).
Spredningsdiagram med timer trening på x-aksen og karakter på y-aksen. Vi ser etter en sammenheng mellom to tall.
Boksplott
Et boksplott viser fordelingen av én tallkolonne med fem tall fra 9.3.1: minste verdi, \(Q_1\), medianen, \(Q_3\) og største verdi. Boksen går fra \(Q_1\) til \(Q_3\), så den inneholder den midterste halvparten. Streken i boksen er medianen. «Værhårene» går ut til de minste og største verdiene som ikke er uteliggere, og uteliggere tegnes som egne prikker.
Boksplott er best når du skal sammenligne fordelingen i flere grupper. Her er skjermtiden fra 9.3.1, delt på trinn:
vg2 = skjerm[skjerm["trinn"] =="vg2"]["timer"]vg3 = skjerm[skjerm["trinn"] =="vg3"]["timer"]fig, ax = plt.subplots()ax.boxplot([vg2, vg3])ax.set_xticks([1, 2], ["vg2", "vg3"])ax.set_title("Skjermtid per trinn")ax.set_xlabel("Trinn")ax.set_ylabel("Timer per dag")plt.show()
ax.boxplot tar en liste med én tallkolonne per boks. Boksene får plass \(1, 2, \ldots\), og set_xticks setter navn på dem. Diagrammet viser at medianen er omtrent lik for de to trinnene, og at uteliggeren på \(14\) timer går på vg2. Et søylediagram med snittet ville skjult alt dette.
Boksen går fra \(Q_1\) til \(Q_3\), streken er medianen, værhårene går ut til minste og største verdi som ikke er uteligger, og prikkene er uteliggere (mer enn \(1{,}5\) kvartilbredder utenfor boksen).
EksempelLes et boksplott
I et boksplott over poeng på en prøve går boksen fra \(20\) til \(35\), medianen er \(28\), værhårene går fra \(8\) til \(50\), og det er én prikk ved \(3\). Hva kan du si om resultatene?
HintHint
Hva er \(Q_1\), \(Q_3\) og kvartilbredden? Hva betyr prikken?
LosningLøsning
Halvparten av elevene fikk mellom \(20\) og \(35\) poeng (kvartilbredden er \(15\)), og den midterste eleven fikk \(28\). Den høyeste fikk \(50\). Én elev fikk bare \(3\) poeng, så langt under de andre at det regnes som en uteligger. Medianen ligger litt over midten av boksen, så det er litt tettere med resultater mellom \(28\) og \(35\) enn mellom \(20\) og \(28\).
Diagrammer som lurer
Et diagram kan vise riktige tall og likevel gi feil inntrykk. Det vanligste er at y-aksen ikke starter på null i et søylediagram:
I diagrammet til venstre ser forskjellen enorm ut, fordi høyden på søylene ikke lenger står i forhold til tallene. Lengden på en søyle er det øyet sammenligner, så søyler skal alltid starte på \(0\). ax.set_ylim(0, 100) bestemmer hvor y-aksen starter og slutter. (plt.subplots(1, 2) gir to diagrammer ved siden av hverandre, se utfordringen i 9.4.1.)
For linjediagram er det annerledes. Der er det endringen du ser på, og det er greit å la y-aksen starte nær dataene, så lenge aksen har tall og det går tydelig fram.
Andre måter et diagram kan lure på:
Utvalgt tidsrom. Viser du bare de årene som passer historien, kan en nedgang se ut som en oppgang.
Ingen enhet eller kilde. «Antall» av hva? Per dag eller per år? Hvem har målt?
Sammenligning av totaler. En stor kommune har flere av alt. Sammenlign heller per innbygger eller i prosent.
3D og pynt. Skrå søyler og skygger gjør det vanskelig å lese av høyden.
RegelEt ærlig diagram
Søyler starter på \(0\) (ax.set_ylim(0, ...)).
Tittel, navn på aksene og enhet. Gjerne kilde.
Hele perioden, eller en god grunn til å velge ut.
Sammenlign andeler eller tall per innbygger når gruppene er ulikt store.
Ingen 3D og unødvendig pynt.
EksempelTall per innbygger
Kommune A har \(120\) innbruddsmeldinger og \(60\,000\) innbyggere. Kommune B har \(30\) meldinger og \(10\,000\) innbyggere. En avis skriver at det er «fire ganger så mange innbrudd i A». Hva er et bedre mål?
HintHint
Regn ut antall per \(1000\) innbyggere.
LosningLøsning
A: \(120 / 60 = 2\) per \(1000\) innbyggere. B: \(30 / 10 = 3\) per \(1000\) innbyggere. Per innbygger er det flere innbrudd i B. Et søylediagram med totaler ville gitt feil inntrykk. Sammenlign med tall per innbygger når gruppene er ulikt store.
Diagrammer for alle
Et diagram skal kunne leses av alle, også på mobil, i svart-hvitt og av de omtrent \(8\) % av guttene som har nedsatt fargesyn (fargeblindhet). Noen enkle regler hjelper mye:
Ikke la farge være eneste forskjell. Bruk også ulike markører (marker="o", marker="s"), linjetyper (linestyle="--") eller skriv navnet rett ved linjen.
Unngå rød mot grønn. Standardfargene i matplotlib er valgt slik at de fleste kan skille dem.
Bruk stor nok tekst og få serier. Fem linjer i samme diagram er sjelden lett å lese.
Skriv en kort tekst ved diagrammet som sier hva det viser. Det hjelper alle, også dem som bruker skjermleser.
Mer om universell utforming kommer i kapittel 10.
AdvarselVanlige feil
Du velger diagram etter hva som ser fint ut, ikke etter spørsmålet.
Søylediagrammet starter ikke på \(0\), så små forskjeller ser store ut.
Du tegner en linje mellom kategorier som ikke har noen rekkefølge.
Du bruker kakediagram med mange små biter.
Du sammenligner totaler for grupper som er svært ulikt store.
Du bruker bare farge for å skille seriene, og det er rødt og grønt.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseVelg diagram
Hvilket diagram passer best? Begrunn kort.
Hvordan strømprisen har endret seg time for time i et døgn.
AnswerFasit
Linjediagram: utvikling over tid.
Hvor mange elever som har valgt hvert programfag.
AnswerFasit
Søylediagram, sortert: sammenligne kategorier.
Hvordan alderen til de som besøker et bibliotek er fordelt.
AnswerFasit
Histogram: fordelingen av én tallkolonne.
Om høyden til en plante henger sammen med hvor mye vann den får.
AnswerFasit
Spredningsdiagram: sammenheng mellom to tall.
Hvordan lengden på filmene er fordelt i tre ulike sjangre.
AnswerFasit
Boksplott med én boks per sjanger: sammenligne fordelinger.
ExerciseLes boksplottet
Et boksplott over reisetiden (minutter) til elevene har boksen fra \(12\) til \(31\), medianen \(20\), værhårene fra \(2\) til \(55\) og to prikker ved \(75\) og \(95\).
Hva er \(Q_1\)?
Hva er kvartilbredden?
Hvor mange uteliggere er det?
Hva er den lengste reisetiden som ikke er en uteligger?
ExerciseHva er galt?
Hva er galt med hvert diagram, og hvordan ville du rettet det?
Et søylediagram over salget i to butikker der y-aksen går fra \(980\) til \(1000\).
AnswerFasit
Søylene starter ikke på \(0\), så en liten forskjell ser stor ut. Sett ax.set_ylim(0, ...).
Et linjediagram med fem fag langs x-aksen og snittkarakter på y-aksen.
AnswerFasit
Fag har ingen rekkefølge, så en linje mellom dem gir ingen mening. Bruk et søylediagram.
Et kakediagram med \(14\) biter, én for hvert fylke.
AnswerFasit
\(14\) biter er umulig å sammenligne. Bruk et sortert søylediagram (gjerne liggende, barh).
Nivå 2
ExerciseSamme tall, to historier
Antall ulykker på en vei var \(40\), \(38\), \(41\), \(37\), \(36\), \(39\), \(25\), \(27\), \(26\) og \(24\) i årene 2016–2025. Det ble satt opp fartskameraer i 2022.
En politiker vil vise at kameraene ikke virket, og viser bare 2022–2025. Hva viser diagrammet?
AnswerFasit
\(25\), \(27\), \(26\), \(24\): omtrent flatt. Det ser ut som ingenting skjer.
Hva viser hele perioden?
AnswerFasit
Rundt \(36\)–\(41\) ulykker før kameraene, og rundt \(24\)–\(27\) etter. Et tydelig fall i 2022.
Hvilket diagram er ærligst, og hva mer bør du sjekke før du konkluderer?
AnswerFasit
Hele perioden, med et merke for 2022. Før du sier at kameraene forårsaket fallet, bør du sjekke om noe annet også endret seg (trafikkmengde, ny vei, fartsgrense), og om andre veier uten kameraer fikk samme fall. Se 9.5.1.
ExerciseSøyler eller boksplott?
Du har poengene til alle elevene i tre klasser. Læreren tegner et søylediagram med gjennomsnittet for hver klasse. Hva får hun ikke fram? Hva ville du tegnet i stedet, og hvorfor?
AnswerFasit
Søylene viser bare ett tall per klasse. De viser ikke hvor spredt resultatene er, om det er uteliggere, eller om snittet er dratt opp eller ned av noen få. To klasser med samme snitt kan være helt ulike (9.3.1). Et boksplott med én boks per klasse viser median, kvartiler og uteliggere, så du ser både nivå og spredning. Har klassene få elever, kan et spredningsdiagram med ett punkt per elev være enda bedre.
ExerciseLag diagrammet tilgjengelig
Et diagram har tre linjer, i rødt, grønt og oransje, uten forklaring og med liten tekst. Skriv hva du ville endret, og skriv koden for én av linjene slik at den skiller seg ut uten farge.
AnswerFasit
Bruk farger som kan skilles også med nedsatt fargesyn (for eksempel standardfargene), gi linjene ulike markører eller linjetyper, legg til label og ax.legend(), og gjør teksten større. Skriv en kort tekst ved diagrammet som sier hva det viser.
ax.plot(x, y, marker="s", linestyle="--",
        label="Klasse B")
Kodeoppgaver
ExerciseVelg diagram med kode
Skriv funksjonen velg_diagram(x, y) som foreslår et diagram. x er "kategori", "tid" eller "tall", og y er "tall" eller None (bare én kolonne). Funksjonen skal gi
"hist" når y er None,
"bar" når x er "kategori",
"plot" når x er "tid",
"scatter" når x er "tall".
Sjekk y is None først, så verdien av x.
ExerciseFinn feilen: søylene lurer
Funksjonen tegner et søylediagram, men y-aksen starter like under den minste verdien. Rett den, slik at y-aksen starter på \(0\).
Den første verdien i set_ylim er der aksen starter.
ExerciseBoksplott per gruppe
Skriv funksjonen tegn_bokser(tabell, gruppe, verdi) som tegner ett boksplott per gruppe (sortert alfabetisk), med gruppenavnene under boksene og verdi som navn på y-aksen.
Lag navn = sorted(tabell[gruppe].unique()) og en liste med én Series per navn. Gi lista til ax.boxplot, og bruk ax.set_xticks(range(1, len(navn) + 1), navn).
Utfordringer
ExerciseSorterte andeler i stedet for kake
Skriv funksjonen andeler_barh(s) som tar en Series med kategorier og tegner liggende søyler (barh) med andelen i prosent for hver kategori. Den største skal stå øverst. Navnet på x-aksen skal være «Andel (%)».
value_counts(normalize=True) * 100 gir andelene med den største først. barh tegner den første nederst, så sorter stigende før du tegner.
ExerciseFinn et villedende diagram
Finn et diagram i en nyhetsartikkel, reklame eller på sosiale medier som du mener er villedende eller vanskelig å lese. Beskriv hva som er galt, og tegn det på nytt med matplotlib, med de samme tallene, slik at det gir et ærlig bilde.
AnswerFasit
Sjekk at du har sagt hva diagrammet påstår, og hva som gjør det villedende (akse som ikke starter på \(0\), utvalgt tidsrom, totaler i stedet for andeler, 3D, manglende enhet eller kilde). Det nye diagrammet skal ha riktig type for spørsmålet, søyler fra \(0\), tittel, navn på aksene med enhet og kilde. Skriv én setning om hva det nye diagrammet viser, og om det er en annen historie enn det opprinnelige.
Søyler fra 0. Enhet og kilde. Hele perioden. Andeler når gruppene er ulike.
Start med spørsmålet, ikke med diagrammet.
Ikke la farge være eneste forskjell mellom seriene.
9.5 Å presentere funn
En analyse er ikke ferdig før noen andre kan forstå og stole på svaret. Denne seksjonen handler om å sette sammen alt i kapittelet, fra spørsmål til konklusjon, og om å si tydelig hva dataene viser og hva de ikke kan vise.
9.5.1 Fra analyse til konklusjon
I månedene der det selges mest is, er det også flest drukningsulykker. Betyr det at is er farlig å spise før du bader? Selvfølgelig ikke. Begge deler skjer når det er varmt. Likevel er det akkurat denne typen feilslutning som gjør at mange konklusjoner fra data er feil, også i aviser og rapporter.
Du har nå lært å lese inn, vaske, beskrive, gruppere og tegne data. I dette siste delkapittelet setter vi det sammen til en hel analyse, og ser på hvordan du går fra tall til en konklusjon som dataene faktisk støtter.
Læringsmål
Etter dette delkapittelet skal du kunne
gjennomføre en analyse i fem steg, fra spørsmål til konklusjon,
regne ut og tolke korrelasjon med corr(),
forklare forskjellen på sammenheng og årsak,
skrive en konklusjon med tall og forbehold, og si hva dataene ikke kan vise.
Fra spørsmål til svar
En analyse følger nesten alltid de samme stegene:
Spørsmål. Hva vil du finne ut? Et godt spørsmål er så konkret at det kan besvares med data: «Hvilken vare gir mest inntekt i kiosken?», ikke «Hvordan går det med kiosken?».
Data. Hvilke data trenger du, og hvor kommer de fra? Hvem har samlet dem inn, når og hvordan?
Vask. Les inn og sjekk dataene. Finn og rett hull, feil og duplikater (9.2.1), og skriv ned hva du gjorde.
Analyse. Beskriv, grupper og tegn (9.3 og 9.4). Se etter mønstre, og se etter det som ikke passer.
Konklusjon. Svar på spørsmålet med tall, og si hvor sikkert svaret er.
Stegene er ikke en rett linje. Ofte oppdager du noe i analysen som gjør at du må tilbake og vaske mer, eller som gir deg et bedre spørsmål. Det er helt vanlig.
Skriv analysen som et program, ikke som klikk i et regneark. Da kan du kjøre den på nytt når det kommer nye data, og andre kan se nøyaktig hva du gjorde. Det kalles at analysen er reproduserbar.
RegelAnalysen i fem steg
Spørsmål: konkret og mulig å besvare.
Data: kilde, tid, hvordan de er samlet inn.
Vask: hull, feil, duplikater. Skriv ned hva du gjorde.
Analyse: beskriv, grupper, tegn.
Konklusjon: svar med tall og forbehold.
EksempelEt godt spørsmål
Gjør spørsmålene mer konkrete, slik at de kan besvares med data. a) «Trives elevene?» b) «Er bussen dårlig?»
HintHint
Hva skal du måle, hos hvem og når?
LosningLøsning
«Hvor stor andel av elevene på vg2 og vg3 svarer 4 eller 5 på spørsmålet om trivsel i elevundersøkelsen i år, og er det forskjell på trinnene?»
«Hvor mange minutter var buss 31 forsinket i snitt (og som median) ved skolen kl. 7–8 i september, og hvor stor andel av avgangene var mer enn fem minutter forsinket?»
Et konkret spørsmål sier hva du skal måle, og gjør det lettere å vite hvilke data du trenger.
Sammenheng er ikke årsak
Her er tall for hver måned i en badeby. Tallene er laget for eksempelets skyld:
Punktene ligger nesten på en rett linje. Når det selges mye is, er det mange ulykker. Korrelasjonen er et tall mellom \(-1\) og \(1\) som sier hvor nær en rett linje punktene ligger:
Nær \(1\): når den ene øker, øker den andre (positiv sammenheng).
Nær \(-1\): når den ene øker, synker den andre (negativ sammenheng).
Nær \(0\): ingen lineær sammenheng.
s1.corr(s2) gir korrelasjonen mellom to kolonner, og t.corr() gir en tabell med korrelasjonen mellom alle tallkolonnene.
Korrelasjonen mellom is og ulykker er \(0{,}99\), men is fører ikke til ulykker. Begge øker når det er varmt, fordi flere spiser is og flere bader. Temperaturen er en skjult variabel som påvirker begge. En høy korrelasjon sier bare at to ting varierer sammen. Den sier ikke hvorfor.
For å vise at noe er en årsak, trenger du mer enn en sammenheng i data: et forsøk der du endrer én ting og holder resten likt, eller en god forklaring på hvordan det skal virke, og at du har utelukket andre forklaringer.
DefinisjonKorrelasjon
s1.corr(s2) # korrelasjonen mellom to kolonnert.corr() # alle tallkolonnene
Korrelasjonen er mellom \(-1\) og \(1\), og måler hvor nær en rett linje punktene i et spredningsdiagram ligger. Sammenheng er ikke det samme som årsak: en skjult variabel kan påvirke begge.
EksempelSkjult variabel
Elever som har PC hjemme, får i snitt bedre karakterer. Kan du konkludere med at skolen bør gi alle elever en PC for å bedre karakterene? Nevn en mulig skjult variabel.
HintHint
Hva annet kan henge sammen med både å ha PC hjemme og å få gode karakterer?
LosningLøsning
Nei, ikke ut fra denne sammenhengen alene. Familier med god økonomi har oftere PC, og barn i slike familier kan også ha andre fordeler: rolig sted å gjøre lekser, foreldre med lang utdanning, mer hjelp. Familiens økonomi og utdanning er mulige skjulte variabler. For å vite om PC-en i seg selv hjelper, måtte du for eksempel gitt PC til noen tilfeldig valgte elever og sammenlignet med dem som ikke fikk.
Hva kan dataene vise?
Selv uten feil i koden kan en konklusjon være feil hvis dataene ikke passer til spørsmålet. Still disse spørsmålene før du konkluderer:
Hvem er med? Er utvalget representativt for dem du vil si noe om? En spørreundersøkelse på Instagram når ikke dem som ikke er på Instagram.
Hvor mange er med? Med fem elever i en gruppe kan én elev endre snittet mye. Oppgi alltid antallet.
Hva mangler? Er det mange hull, og er det bestemte grupper som mangler (9.2.1)?
Hva er målt? «Trivsel» målt med ett spørsmål på en skala fra 1 til 5 er ikke det samme som trivsel.
Gjelder det andre steder og tider? Tall fra én skole eller ett år kan ikke uten videre brukes på alle.
Det betyr ikke at du ikke kan konkludere. Det betyr at konklusjonen skal si hva den bygger på, og hvor langt den rekker. Det er det som gjør den til å stole på.
Skrive konklusjonen
En god konklusjon har tre deler:
Svaret på spørsmålet, med ord.
Tallene som viser det, med enhet og antall.
Forbeholdene: hva dataene ikke viser, og hva som kunne vært undersøkt videre.
Her er en analyse av kiosken fra 9.3.2, skrevet som et program som også lager teksten:
inntekt = kiosk.groupby("vare")["inntekt"].sum()totalt = inntekt.sum()best = inntekt.idxmax()andel = inntekt[best] / totalt *100dager = kiosk["dag"].nunique()print(f"{best} ga mest inntekt: {inntekt[best]} kr av "f"{totalt} kr ({andel:.0f} %) på {dager} dager.")
Kaffe ga mest inntekt: 2360 kr av 3811 kr (62 %) på 4 dager.
Tallene i teksten kommer rett fra dataene, så teksten blir riktig også når det kommer nye data. Konklusjonen kan bli slik:
Kaffe gir mest inntekt i kiosken: \(2360\) kroner av \(3811\) (\(62\) %) i løpet av fire dager. Boller er nummer to med \(1250\) kroner. Dataene gjelder bare én uke, og fredag mangler. Te og saft er bare registrert én dag hver, så vi vet lite om dem. For å vite om det lønner seg å selge mer kaffe, må vi også vite hva varene koster i innkjøp.
Legg merke til at konklusjonen svarer på spørsmålet først, bruker tall med enhet, og sier tydelig hva den ikke kan svare på. Den skriver «gir mest inntekt i denne uka», og ikke «kaffe er den beste varen».
RegelEn god konklusjon
Svar på spørsmålet først, med ord.
Bruk tall med enhet, og oppgi hvor mange det bygger på.
Bruk ett godt diagram som viser hovedpoenget.
Si hva dataene ikke kan vise: utvalg, hull, tidsrom, sammenheng mot årsak.
Skriv analysen som kode, så den kan kjøres på nytt.
EksempelFor sterk konklusjon
En elev skriver: «Elever som bruker mer enn fem timer på mobilen, får dårligere karakterer. Mobilen ødelegger skoleresultatene.» Tallene kommer fra en spørreundersøkelse med \(40\) elever på én skole, og korrelasjonen mellom skjermtid og snittkarakter er \(-0{,}35\). Skriv konklusjonen på nytt.
HintHint
Er \(-0{,}35\) en sterk sammenheng? Viser en sammenheng årsak? Hvem er med?
LosningLøsning
«Blant de \(40\) elevene som svarte, er det en svak negativ sammenheng mellom skjermtid og snittkarakter (korrelasjon \(-0{,}35\)): de som bruker mye tid på mobilen, har i snitt litt lavere karakterer, men med store forskjeller. Dataene viser ikke at mobilbruken er årsaken. Det kan for eksempel være at elever som trives dårlig, både bruker mobilen mer og får lavere karakterer. Utvalget er lite og fra én skole, og skjermtiden er oppgitt av elevene selv.»
AdvarselVanlige feil
Du konkluderer med årsak («fører til», «gjør at») ut fra en sammenheng.
Du oppgir et snitt uten antall, eller snitt for grupper med svært få.
Du sier noe om «alle elever» ut fra et lite eller skjevt utvalg.
Du skjuler hvordan du vasket dataene. Andre kan da ikke vurdere resultatet.
Du bruker ord som «bevis» og «alltid». Data gir støtte, med usikkerhet.
Du lar konklusjonen gå lenger enn spørsmålet. Svar på det du spurte om.
Du tolker en korrelasjon nær \(0\) som at det ikke er noen sammenheng. Det kan være en sammenheng som ikke er en rett linje. Se alltid på spredningsdiagrammet.
Oppgaver
Start på nivå 1. Når du får til de fleste oppgavene på et nivå, går du videre til neste. Utfordringene til slutt er for deg som vil prøve deg på noe vanskeligere.
Nivå 1
ExerciseTolk korrelasjonen
Hva betyr korrelasjonen? Beskriv sammenhengen med ord.
Antall timer trening og hvilepuls: \(-0{,}7\)
AnswerFasit
Ganske sterk negativ sammenheng: de som trener mye, har ofte lavere hvilepuls.
Skostørrelse og karakter i matematikk: \(0{,}02\)
AnswerFasit
Ingen sammenheng.
Utetemperatur og strømforbruk i en enebolig: \(-0{,}9\)
AnswerFasit
Sterk negativ sammenheng: kaldere vær gir høyere strømforbruk (oppvarming).
Antall solgte billetter og inntekt for en kino: \(1{,}0\)
AnswerFasit
Perfekt positiv sammenheng: inntekten er antall billetter ganger prisen, så punktene ligger på en rett linje.
ExerciseHva er riktig konklusjon?
Korrelasjonen mellom antall brannbiler som rykker ut til en brann og skadene i kroner er \(0{,}8\). Hvilken konklusjon er riktig?
Brannbilene gjør skade, så det bør sendes færre.
Store branner gir både flere brannbiler og større skader.
Det er ingen sammenheng.
AnswerFasit
b). Størrelsen på brannen er den skjulte variabelen. Den bestemmer både hvor mange biler som sendes og hvor store skadene blir. a) er en klassisk feilslutning fra sammenheng til årsak. c) er feil, siden \(0{,}8\) er en sterk sammenheng.
ExerciseRegn ut med pandas
Bruk tabellen by fra teorien.
Hva er korrelasjonen mellom temp og is, avrundet til to desimaler?
Hvor mange ulykker var det til sammen i månedene med temperatur over \(10\) grader?
Hvor stor andel av alle ulykkene er det, i prosent?
Nivå 2
ExerciseVurder utvalget
Et treningssenter spør sine egne medlemmer hvor mange timer de trener i uka, og skriver: «Nordmenn trener i snitt seks timer i uka.» Hva er problemet? Hvordan kunne konklusjonen vært skrevet?
AnswerFasit
Utvalget er ikke representativt: medlemmer på et treningssenter trener mer enn folk flest, og de som svarer, er kanskje de mest aktive. Konklusjonen kan bare si noe om medlemmene som svarte. Bedre: «Medlemmene som svarte på undersøkelsen (\(n = \ldots\)), trener i snitt seks timer i uka (median …).» Skal du si noe om nordmenn, trenger du et tilfeldig utvalg av hele befolkningen.
y synker med \(2\) hver gang x øker med \(1\), så punktene ligger på en fallende rett linje: \(-1\). x * 2 ligger på en stigende rett linje: \(1\). z har ingen tydelig sammenheng med x, så korrelasjonen er svak. Uten round ville du fått -0.9999999999999999, fordi desimaltall ikke lagres helt nøyaktig.
ExerciseKorrelasjon nær null
Tallene under viser hvor godt en gruppe presterer (y) ved ulik grad av stress (x, fra 1 til 7):
x.corr(y) er \(0\) (pandas skriver kanskje et svært lite tall, som 3.35e-17, av samme grunn som over).
Tegn et spredningsdiagram. Hva ser du?
AnswerFasit
Punktene danner en bue: prestasjonen øker opp til middels stress og synker etterpå.
Hva lærer du av dette?
AnswerFasit
Korrelasjonen måler bare om punktene ligger nær en rett linje. Her er det en tydelig sammenheng, men den er ikke lineær. Se derfor alltid på spredningsdiagrammet, og ikke bare på tallet.
Kodeoppgaver
ExerciseSterkeste sammenheng
Skriv funksjonen sterkest(tabell, kolonne) som gir navnet på den andre tallkolonnen som har sterkest korrelasjon med kolonne. Sterkest betyr størst tallverdi, så \(-0{,}9\) er sterkere enn \(0{,}5\).
tabell.corr()[kolonne] gir korrelasjonen med alle kolonnene. Fjern kolonnen selv med drop(kolonne), bruk abs() og idxmax().
ExerciseKonklusjon fra data
Skriv funksjonen konklusjon(tabell) som tar en tabell med kolonnene vare og inntekt og gir en setning som denne:
Kaffe ga mest inntekt: 2360 kr (62 % av 3811 kr).
Prosenten skal være avrundet til et helt tall.
Grupper og summer per vare. idxmax() gir varen, og en f-streng med :.0f runder prosenten.
ExerciseFinn feilen: per innbygger
Funksjonen skal gi kommunen med flest innbrudd per innbygger, men gir kommunen med flest innbrudd. Rett den.
Regn ut innbrudd per innbygger (tabell["innbrudd"] / tabell["innbyggere"]) og finn den største.
Utfordringer
ExerciseHele analysen
Skriv funksjonen analyser(tekst) som tar en norsk CSV-tekst (semikolon, desimalkomma, .. for manglende) med kolonnene klasse og poeng, og gir en ordbok med
"rader": antall rader etter at radene uten poeng og duplikatene er fjernet,
"best": klassen med høyest median,
"median": medianen for den klassen.
Les med sep, decimal og na_values (9.1.2), bruk dropna og drop_duplicates (9.2.1), og så groupby("klasse")["poeng"].median() med idxmax() (9.3.2).
ExerciseLag din egen analyse
Finn et åpent datasett (for eksempel fra SSB, Yr, Entur eller kommunen din), og gjennomfør en hel analyse:
Skriv ett konkret spørsmål.
Les inn dataene og beskriv dem (kilde, rader, kolonner).
Vask dem, og skriv ned hva du gjorde.
Svar på spørsmålet med statistikk, gruppering og ett godt diagram.
Skriv en konklusjon med tall og forbehold.
Lagre dataene som en fil, så analysen virker uten nett.
AnswerFasit
Sjekk at spørsmålet er konkret, at kilden og tidsrommet er oppgitt, at vaskingen er beskrevet (hull, feil, duplikater), at diagrammet har riktig type, starter på \(0\) for søyler og har tittel og akser med enhet, og at konklusjonen svarer på spørsmålet med tall, oppgir antall og har forbehold (utvalg, hull, sammenheng mot årsak). Analysen skal kunne kjøres på nytt fra filen. Dette er også starten på prosjekt P3.
Oppsummering
Fem steg
Spørsmål
Data
Vask
Analyse
Konklusjon
Korrelasjon
s1.corr(s2)t.corr()
Fra \(-1\) til \(1\). Sammenheng er ikke årsak.
Konklusjon
Svar først
Tall, enhet og antall
Forbehold
En korrelasjon nær \(0\) kan skjule en sammenheng som ikke er en rett linje. Se på spredningsdiagrammet.
Si hva dataene ikke kan vise: utvalg, hull, tidsrom, årsak.
Disse oppgavene blander temaene fra hele kapittelet. Flere oppgaver finner du i notatboka (lenkene øverst i kapittelet).
ExerciseHvilket verktøy?
Hvilken metode eller funksjon bruker du? a) Lese en CSV-fil fra SSB. b) Finne ut hvor mange verdier som mangler i hver kolonne. c) Få bare radene der pris er over \(100\). d) Finne snittet per klasse. e) Vise fordelingen av reisetid. f) Måle om to tallkolonner henger sammen.
AnswerFasit
pd.read_csv(..., sep=";", decimal=",", na_values=".."). b) t.isna().sum(). c) t[t["pris"] > 100]. d) t.groupby("klasse")["poeng"].mean(). e) ax.hist eller ax.boxplot. f) s1.corr(s2) og et spredningsdiagram.
ExerciseFra rå tekst til svar
Skriv funksjonen snitt_per_by(tekst) som tar en norsk CSV-tekst med kolonnene by og temp og gir en ordbok med gjennomsnittstemperaturen for hver by, avrundet til én desimal. Bynavnene kan ha mellomrom i endene og ulik bruk av store og små bokstaver, og temperaturen \(-999\) betyr at målingen mangler.
Les med sep, decimal og na_values=["..", -999]. Rydd by med str.strip().str.capitalize(), grupper og bruk mean(), round(1) og to_dict().
ExerciseDiagram for et spørsmål
Skriv funksjonen tegn_snitt(tabell, gruppe, verdi) som tegner et søylediagram med gjennomsnittet av verdi for hver gruppe, sortert med den høyeste først. Navnet på y-aksen skal være "Snitt " + verdi, og y-aksen skal starte på \(0\).
Grupper, ta mean() og sorter synkende. Tegn med fig, ax = plt.subplots() og ax.bar(s.index, s.values), og husk return ax.
ExerciseVurder en analyse
En elev har undersøkt om elever som spiller dataspill mye, får lavere karakterer. Hun spurte \(25\) venner på Snapchat, fjernet tre svar som «så rare ut», fant korrelasjonen \(-0{,}4\) og konkluderte: «Dataspill gir dårligere karakterer.» Gi henne tre konkrete råd.
AnswerFasit
Utvalget: \(25\) venner er få og ikke representativt for elever flest. Skriv hvem som er med, og ikke si noe om alle elever.
Vaskingen: Å fjerne svar fordi de «ser rare ut» kan påvirke resultatet. Fjern bare svar som er åpenbart feil (umulige verdier), skriv hvilke og hvorfor, og sjekk om konklusjonen endrer seg.
Konklusjonen: \(-0{,}4\) er en moderat negativ sammenheng, ikke et bevis for årsak. Skriv «elevene som spiller mye, har i snitt litt lavere karakterer», og nevn mulige skjulte variabler (søvn, trivsel, tid til lekser). Vis spredningsdiagrammet.
ExerciseEksamensøving
På skriftlig eksamen får du en CSV-fil med data, uten nett. Lag deg en øvingsfil med minst \(50\) rader (gjerne fra et åpent datasett du har lastet ned), og skriv et program som
leser filen og skriver ut shape, dtypes og antall manglende verdier,
vasker dataene og skriver ut hva som ble endret,
svarer på to spørsmål med gruppering og statistikk,
tegner ett diagram som svarer på det ene spørsmålet, og lagrer det som PNG,
skriver ut en konklusjon med tall fra dataene.
Gjør det på tid, uten KI og uten nettsøk, bare med help(), dir() og notatene dine.
AnswerFasit
Sjekk at programmet virker uten nett, at innlesingen har riktige parametere (sjekk dtypes), at vaskingen er skrevet ned, at spørsmålene er besvart med riktig metode (groupby med valgt kolonne, median eller snitt etter hva dataene tåler), at diagrammet har riktig type, tittel, akser med enhet og søyler fra \(0\), og at konklusjonen bruker tall fra koden og har forbehold. Noter hva du måtte slå opp, og øv på det.